
چرا سایت برای بعضی کاربران باز نمیشود؟ مانیتورینگ سرور و مسیر شبکه
سرور سالم است و Nginx خطای خاصی ندارد، اما کاربران Timeout میبینند؟ راهنمای مانیتورینگ قطعی منطقهای، HTTP، DNS، TCP، TLS، Packet Loss و مسیر CDN تا Origin.
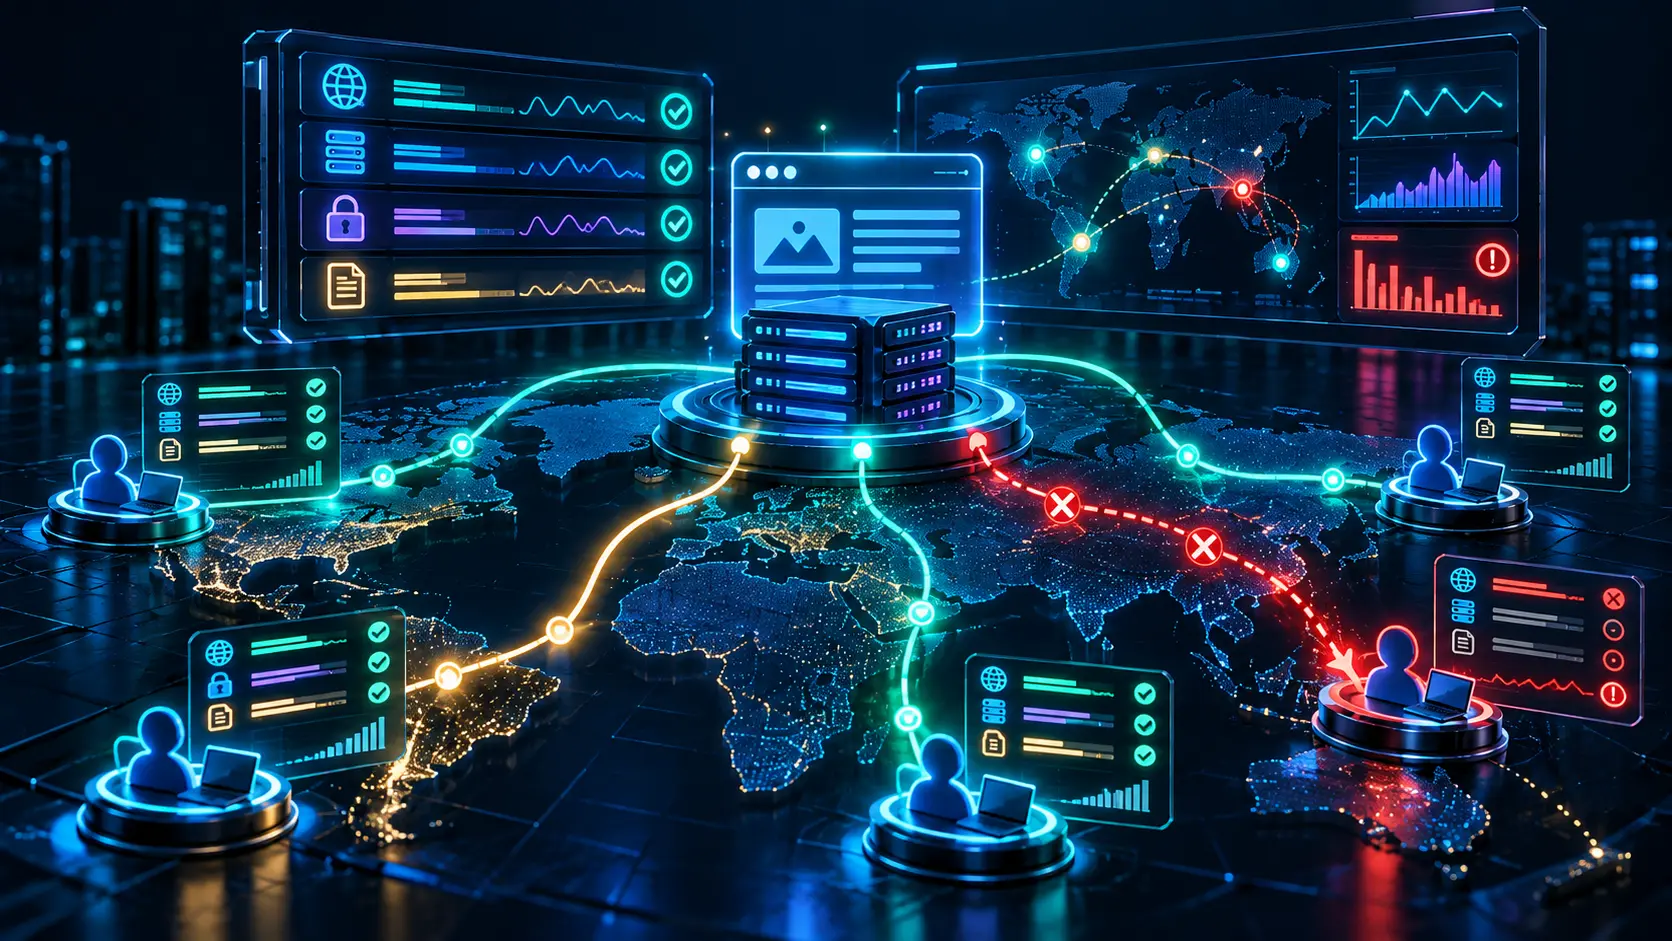
داشبورد میگوید CPU طبیعی است، دیتابیس کار میکند و Nginx پاسخ HTTP ۲۰۰ میدهد. اما مشتریان بعضی شهرها یا کشورها میگویند صفحه باز نمیشود. برای یک کسبوکار آنلاین، این یکی از خطرناکترین وضعیتهاست: سرور از داخل سالم به نظر میرسد، اما کاربران واقعی سرویس را دریافت نمیکنند. در چنین شرایطی، مانیتورینگ سرور باید از مشاهده منابع سختافزاری فراتر برود و مسیر کامل درخواست را ببیند.
این مقاله یک راهنمای تخصصی برای مانیتورینگ دسترسپذیری وبسایت، تشخیص قطعی منطقهای، عیبیابی DNS و TLS و تحلیل کیفیت مسیر شبکه است. یاد میگیریم چرا تست HTTP ۲۰۰ همیشه کافی نیست، تفاوت خطای سرور با Packet Loss چیست و چگونه از چند نقطه بررسی مستقل، داده قابلاقدام بسازیم؛ بدون اینکه برای هر Timeout، برنامه یا سرور را بیدلیل Restart کنیم.
آپتایم واقعی با روشنبودن Nginx یکسان نیست
آپتایم را میتوان از چند زاویه اندازه گرفت: روشنبودن پردازش، پاسخدادن یک پورت، ارسال پاسخ HTTP و کاملشدن مسیر موردنیاز کاربر. هرکدام پرسش متفاوتی جواب میدهد. وبسروری که پاسخ ۲۰۰ به یک درخواست ساده میدهد، لزوماً نمیتواند صفحه محصول همراه با JavaScript، تصاویر و فراخوانی API را برای همه کاربران بارگذاری کند.
از سوی دیگر، ممکن است مرورگر کاربر مشکل داشته باشد، یک CDN یا شبکه منطقهای با اختلال روبهرو شود، یا تنها مسیر یک دیتاسنتر خاص به مبدأ ناپایدار باشد. برای تشخیص این حالتها به پایش End-to-End، سنجش چندنقطهای و همبستگی لاگها با ترافیک شبکه نیاز داریم.
چهار سطح مشاهده سلامت وبسایت
- Process Health: آیا Nginx، PHP-FPM، دیتابیس و Workerهای ضروری واقعاً اجرا میشوند؟
- Service Health: آیا درخواست واقعی HTTP/HTTPS یا API پاسخ معتبر دریافت میکند؟
- Network Reachability: آیا مسیر DNS، TCP و TLS از محل کاربر کامل میشود؟
- User Experience: آیا صفحه در زمان قابلقبول، همراه با منابع لازم، برای کاربر قابلاستفاده میشود؟
اگر این چهار سطح را در یک عدد «UP» خلاصه کنیم، احتمال گمراهکنندهشدن داشبورد زیاد است. بهتر است هر لایه، شاخص و مسئول بررسی خودش را داشته باشد.
چرا HTTP ۲۰۰ ممکن است یک نتیجه اشتباه ایجاد کند؟
کد HTTP ۲۰۰ یعنی سرویس در سطح پروتکل یک پاسخ موفق اعلام کرده است. اما لاگ وبسرور ممکن است ثبت کند که پاسخ به سوکت محلی تحویل داده شده، درحالیکه مرورگر دوردست تمام بایتها را دریافت نکرده است. همچنین ممکن است HTML رسیده باشد اما فایل CSS یا API فرعی دریافت نشود. بنابراین موفقیت درخواست را بهصورت انتهابهانتها و برای محتوای موردانتظار تعریف کنید.
TTFB، زمان دانلود و کاملشدن پاسخ
TTFB زمان تا دریافت اولین بایت پاسخ است. این متریک برای تشخیص تأخیر اولیه مهم است، اما درباره دریافت کامل پاسخ یا آمادهشدن رابط کاربری چیزی نمیگوید. مانیتوری که فقط Headerها را میخواند ممکن است خطای انتقال فایل بزرگ، Timeout میانی یا قطع Streaming را تشخیص ندهد. برای صفحات مهم، دریافت کامل Body یا بررسی محتوای موردانتظار را هم در سناریوی پایش داشته باشید.
برای نمونه، در یک مسیر کند ممکن است DNS و TLS در ۱۰۰ میلیثانیه کامل شوند و اولین بایت در ۲۰۰ میلیثانیه برسد، اما دانلود تصویر اصلی یا ادامه پاسخ برای چند ثانیه متوقف شود. نمودار TTFB بهتنهایی این مشکل را نشان نمیدهد؛ باید زمان دانلود کامل و کیفیت شبکه را نیز اندازه گرفت.
نقشه عیبیابی شبکه؛ DNS تا دریافت آخرین بایت
مسیر بازشدن یک صفحه معمولاً شامل Resolve دامنه، برقراری اتصال TCP، Handshake امن TLS، ارسال درخواست HTTP، دریافت Header و دریافت کامل Body است. برای هر مرحله یک نوع شکست وجود دارد. این جدول کمک میکند سریعتر لایه مسئله مشخص شود:
| مرحله | نشانه خطا | چه چیزی را بررسی کنیم؟ |
|---|---|---|
| DNS | دامنه Resolve نمیشود یا IP اشتباه است | رکورد A/AAAA، Resolver و TTL |
| TCP | اتصال Timeout یا Reset میشود | Firewall، مسیر، وضعیت پورت، SYN و ACK |
| TLS | Handshake شکست میخورد یا گواهی معتبر نیست | SNI، زنجیره گواهی، نسخه TLS و تجهیزات میانی |
| HTTP | ۴xx/۵xx یا پاسخ غیرمنتظره | Route، برنامه، Proxy و سرویس بالادستی |
| Body Transfer | اولین بایت میرسد اما دانلود کامل نمیشود | Retransmission، MTU، Packet Loss و مسیر برگشت |
| Frontend | HTML رسیده اما صفحه ناقص است | CSS/JS، APIهای فرعی، خطاهای مرورگر و CDN |
اینها سرنخاند، نه تشخیص قطعی. مثلاً Timeout در TCP میتواند به فایروال یا مسیر شبکه مربوط باشد؛ اما بدون Capture و تست تکمیلی نمیتوان یکی را مقصر اعلام کرد.
مانیتورینگ چندموقعیتی؛ چرا نتیجه یک دیتاسنتر کافی نیست؟
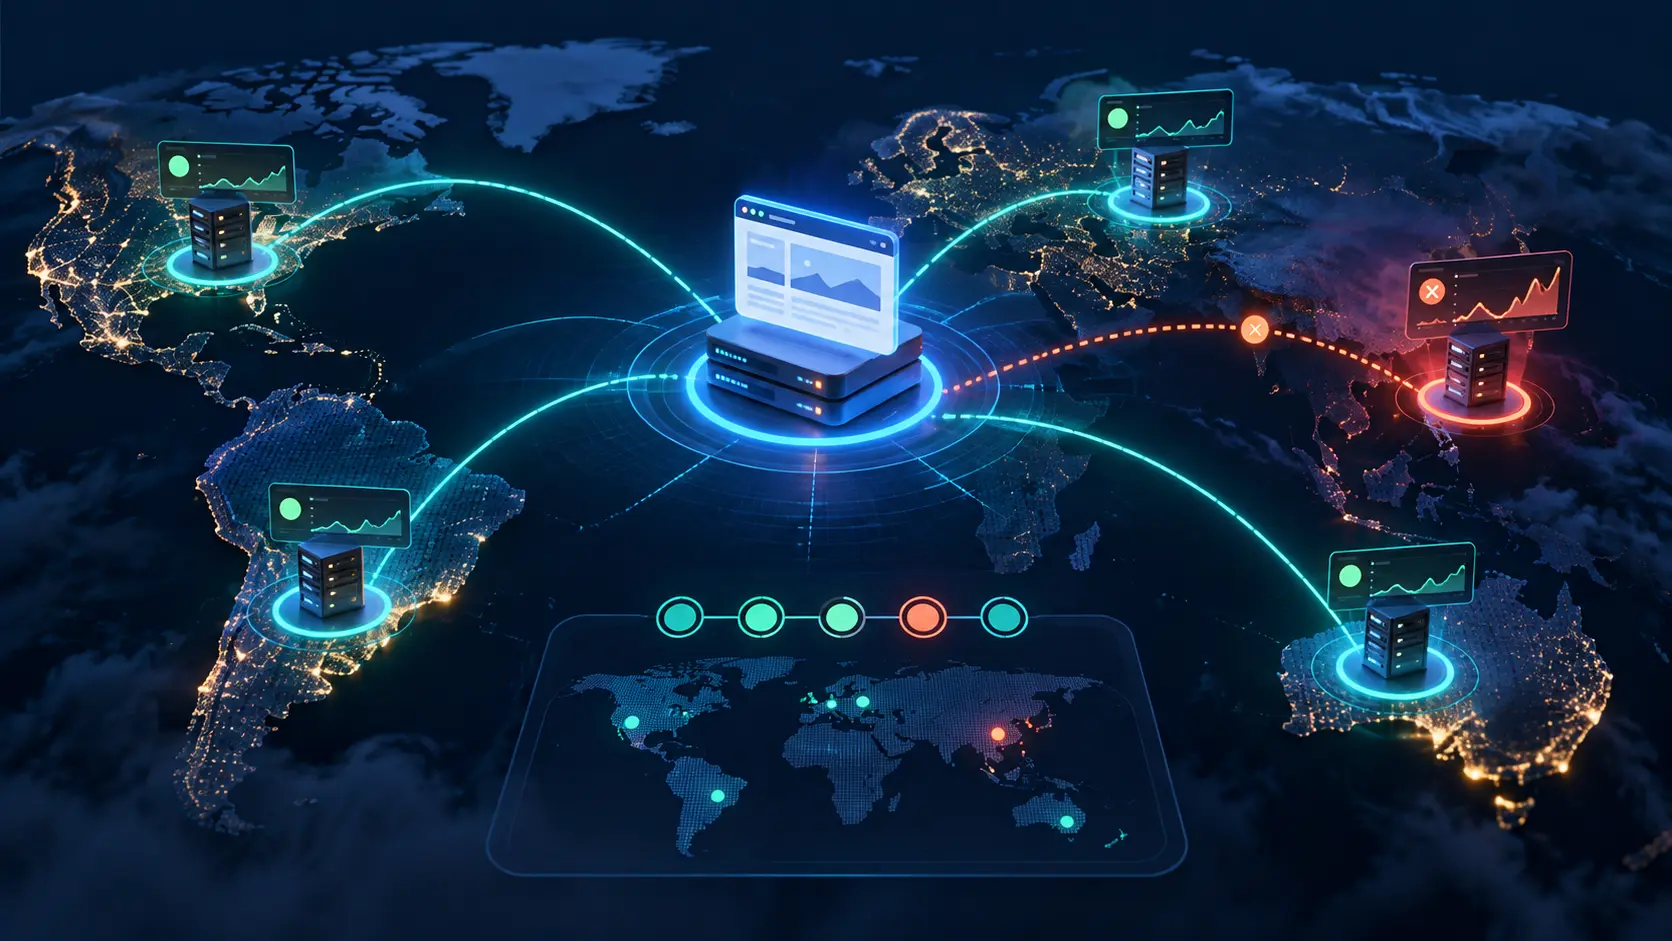
اگر سایت شما هم مخاطب داخل ایران و هم کاربر خارجی دارد، بهتر است سلامت از چند شبکه مستقل اندازهگیری شود. یک مانیتور نزدیک سرور میتواند کاملاً سبز باشد، ولی مسیر کاربران خارج از کشور مشکل داشته باشد. برعکس، خرابی یکی از مسیرهای بیرونی ممکن است بدون ایجاد اختلال سراسری رخ دهد.
در Multi-Location Monitoring هر نتیجه باید با موقعیت، شبکه مبدأ، نسخه پروتکل، زمان و نوع بررسی ثبت شود. وقتی تنها یک نقطه خطا دارد، ابتدا همان مسیر را بررسی کنید؛ وقتی چند نقطه مستقل همزمان شکست میخورند، احتمال خرابی گستردهتر بیشتر است. بااینحال حتی ده مانیتور موفق نمیتوانند سلامت از دید تمام کاربران اینترنت را تضمین کنند.
الگوی عملی تشخیص قطعی منطقهای
- زمان اولین گزارش کاربران را با ساعت دقیق و منطقه زمانی ثبت کنید.
- همان URL را از مبدأ سرور، یک شبکه داخل کشور و چند شبکه بیرونی بررسی کنید.
- به جای فقط Ping، وضعیت اتصال TCP، TLS و دریافت کامل HTTP را ثبت کنید.
- خطاهای رخداده در Nginx، برنامه و تجهیزات امنیتی را با زمان تستها تطبیق دهید.
- اگر لاگ سرور HTTP ۲۰۰ دارد ولی کلاینت Timeout میگیرد، مسیر انتقال و بازفرستادن بستهها را بررسی کنید.
- پس از تغییر هر تنظیم، همان تست را از همان موقعیتها تکرار و نتیجه قبل/بعد را مستند کنید.
برای سایت دارای CDN، باید سلامت مسیر کاربر ← CDN و CDN ← Origin جدا سنجیده شود. CDN میتواند بعضی مشکلات مسیر کاربر را کاهش دهد، اما اگر خود CDN به Origin دسترسی مطمئن نداشته باشد، نتیجه همیشه بهتر نخواهد شد.
Packet Loss و Retransmission چه تأثیری روی سایت دارند؟
در TCP، دادههای دریافتنشده دوباره ارسال میشوند. اگر بخشی از بستههای مسیر در رفت یا برگشت گم شود، اتصال میتواند برقرار بماند اما سرعت دانلود افت کند؛ گاهی هم تا پایان Timeout کاربر، بخشهایی از پاسخ نمیرسند. در این وضعیت، مصرف CPU سرور ممکن است طبیعی باشد و نمودار دسترسی داخلی چیزی نشان ندهد.
Packet Loss همیشه از یک علت ناشی نمیشود: ازدحام لینک، خطای مسیر، سیاست تجهیزات امنیتی، اختلال مجازیسازی یا برخی مشکلات MTU میتوانند نقش داشته باشند. بررسی باید بر پایه شواهد باشد؛ اگر از فقط یک سمت Capture بگیرید، ممکن است نتوانید تأیید کنید بسته در سمت دیگر واقعاً چه سرنوشتی داشته است.
برای عیبیابی دقیق چه دادههایی حفظ کنیم؟
- زمان رخداد، IP مقصد یا شناسه سرویس و نسخه IPv4/IPv6، بدون افشای داده شخصی مشتری.
- مرحله شکست: DNS، TCP، TLS، First Byte یا Body Transfer.
- زمان اتصال، تعداد تلاش مجدد و مدت پاسخ؛ با تفکیک موقعیت تست.
- کد HTTP و حجم بدنهای که کلاینت واقعاً دریافت کرده است.
- لاگ متناظر Reverse Proxy و در صورت مجازبودن، Capture محدود و محافظتشده.
- تغییرات همزمان در فایروال، CDN، DNS یا زیرساخت میزبان.
قبل از گرفتن Packet Capture، سیاست حفظ حریم خصوصی و مجوزهای سازمان را بررسی کنید؛ Capture ممکن است شامل داده حساس شبکه باشد و نباید بهصورت عمومی منتشر شود.
چه زمانی مشکل از برنامه است و چه زمانی از شبکه؟
اگر پاسخ HTTP ۵۰۰ بههمراه Exception در لاگ برنامه دیده میشود، احتمال اشکال در برنامه یا وابستگیهایش بالاست. اگر روی Origin پاسخ کامل دریافت میشود ولی فقط از یک شبکه دوردست Timeout رخ میدهد، بررسی مسیر ارتباط ارزش بیشتری دارد. بااینحال نباید صرفاً از روی یک نشانه نتیجه بگیریم: ممکن است Load Balancer، WAF، Rate Limit یا پیکربندی TLS فقط برخی درخواستها را تحت تأثیر قرار داده باشد.
یک راهکار عملی، ثبت Correlation ID برای درخواست و اتصال رویدادهای Nginx، برنامه و سرویس بالادستی به همان شناسه است. برای خطاهای سمت کاربر که اصلاً به Origin نرسیدهاند، ثبت نتایج Probe بیرونی اهمیت بیشتری دارد. این دو منبع به هم کمک میکنند اما هیچکدام جای دیگری را نمیگیرند.
مانیتورینگ مسیرهای حیاتی بهتر از بررسی صرف صفحه اصلی است
صفحه اصلی سایت ممکن است از کش سریع پاسخ دهد؛ اما مسیر ورود، API حساب کاربری یا سفارشگذاری به دیتابیس، Session و سرویسهای بیرونی وابسته است. بهتر است برای هر مسیر حیاتی یک تست متناسب طراحی شود، بدون اینکه تست پرداخت ناخواسته پول واقعی جابهجا کند یا داده حساس کاربران را تغییر دهد.
| مسیر | چه چیزی را بررسی کنیم؟ | نکته امنیتی |
|---|---|---|
| صفحه عمومی | HTTP 200، محتوای مورد انتظار و زمان پاسخ | از محتوای پایدار برای صحتسنجی استفاده کنید |
| ورود کاربر | سلامت Endpoint و وابستگی Session/Database | اعتبار حساب تست و محدودیت تلاش مهم است |
| API حساس | کد پاسخ، Schema و مدت پردازش | درخواستهای تست باید مجاز و بدون داده واقعی باشند |
| پرداخت | آمادگی مسیر Checkout و Callback | تراکنش واقعی آزمایشی بدون مجوز ایجاد نکنید |
| دانلود فایل | دریافت کامل چند حجم نمونه و Hash در صورت نیاز | از فایل تستی عمومی استفاده کنید |
| سرویس وابسته | ارتباط داخلی، Timeout و درصد خطا | داده محرمانه در Probe ذخیره نشود |
مانیتورینگ سرور باید هم از خارج سرویس را ببیند و هم با متریکهای داخلی مثل وضعیت دیتابیس و PHP-FPM علت احتمالی خطا را پیدا کند. این کار زمان عیبیابی را کاهش میدهد اما جایگزین تحلیل ریشهای نیست.
تفاوت Liveness و Readiness در زمان Deploy
Liveness بررسی میکند پردازش زنده است؛ Readiness میپرسد آیا نمونه همین حالا میتواند ترافیک واقعی بپذیرد. اگر در Health Check همه چیز، از SSL بیرونی تا Scheduler، بدون اولویتبندی کنار هم قرار بگیرد، یک بررسی جانبی گذرا ممکن است کل Deploy را ناموفق اعلام کند؛ حتی وقتی سایت پاسخ درست میدهد.
برای طراحی بهتر، وابستگیهای واقعاً حیاتی مانند اتصال دیتابیس ضروری را در Readiness نگه دارید. بررسیهایی مانند تاریخ انقضای گواهی، وضعیت Job زمانبندیشده و برخی اعلانهای جانبی را جداگانه گزارش کنید؛ شکست آنها باید دیده و پیگیری شود، ولی همیشه دلیل خارجکردن فوری برنامه از سرویس نیست. در مقابل، اگر برنامه بدون دیتابیس نمیتواند هیچ سفارش مهمی را پردازش کند، Readiness نباید بهدروغ موفق بماند.
چرا بررسی سلامت از خارج دیتاسنتر برای Deploy کافی نیست؟
اگر فرایند انتشار روی Origin اجرا میشود اما Readiness فقط از یک شبکه بیرون سنجیده شود، اختلال مسیر شبکه میتواند باعث شکست اشتباه Deploy شود. بهتر است آمادگی خود برنامه از مسیر محلی معتبر بررسی شود و سلامت دسترسپذیری عمومی با مانیتورهای بیرونی مستقل اندازهگیری شود. این تفکیک مشکل شبکه را پنهان نمیکند؛ فقط علتهای متفاوت را با یک وضعیت واحد اشتباه نمیگیرد.
SSL و DNS؛ دو منبع قطعی که CPU را تغییر نمیدهند
انقضای گواهی SSL، تغییر اشتباه DNS یا پیکربندی نادرست رکوردهای A/AAAA ممکن است باعث شود کاربران صفحه هشدار امنیتی ببینند یا اصلاً به مقصد نرسند، بدون اینکه روی CPU Origin اثر بزرگی دیده شود. برای هر دامنه مهم، حداقل زمان انقضای گواهی و تطابق نام دامنه را زیر نظر بگیرید. در تغییر DNS، TTL قبلی، وضعیت Resolverهای مختلف و امکان Rollback اهمیت دارند.
برای سایتهای دارای چند دامنه یا زیردامنه، مسیرهای پرداخت، پنل، API و CDN میتوانند گواهی یا تنظیمات متفاوتی داشته باشند. تست تکدامنهای کافی نیست؛ هر Host حیاتی باید با SNI و مسیر HTTPS واقعی خود بررسی شود.
تستهای Synthetic و داده کاربران واقعی؛ مکمل یکدیگر
Synthetic Monitoring از نقاط مشخص بهصورت برنامهریزیشده مسیرهای سرویس را تست میکند. این روش کنترلشده و قابل تکرار است، اما فقط همان سناریوها و شبکههای انتخابشده را میبیند. در مقابل، داده Real User Monitoring میتواند تجربه واقعی مرورگرها را نشان دهد، ولی به رضایت، حریم خصوصی، نمونه کافی و کیفیت ثبت رویداد وابسته است.
برای تحلیل درست، شاخصهای تجربه کاربر مثل زمان بارگذاری و شکست بارگیری منابع را با داده Synthetic و وضعیت Origin کنار هم قرار دهید. اگر تنها کاربران یک اپراتور شبکه خطا دارند، نتیجه را نباید به همه کاربران تعمیم داد؛ اگر هم تمام Probeها سالماند ولی تعداد زیادی از کاربران خطا گزارش میکنند، سناریوهای پایش ناکافیاند یا داده باید دقیقتر جمع شود.
چگونه گزارش قطعی قابلاعتماد بسازیم؟
یک گزارش خوب فراتر از اعلام «سرور ۹۹٫۹٪ آنلاین بود» است. بازه زمانی دقیق، روش اندازهگیری، محل Probeها، تعداد خطاهای متوالی، وضعیت کاملشدن Body و محدودیتهای تست باید مشخص باشند. برای مثال، گزارش ۹۹٫۹٪ آپتایم بر اساس یک Ping هر پنج دقیقه لزوماً نشاندهنده سلامت مسیر خرید آنلاین نیست.
محاسبه زمان قطعی از درصد دسترسپذیری
اگر یک ماه را دقیقاً ۳۰ روز فرض کنیم، ۹۹٫۹٪ دسترسپذیری یعنی حداکثر حدود ۴۳٫۲ دقیقه عدم دسترسی در همان بازه. اما این محاسبه وابسته به تعریف روشن «موفقیت»، فاصله بررسیها و شیوه برخورد با پنجرههای نگهداری است. از عدد آپتایم بدون شرح روش محاسبه برای مقایسه قطعی دو سرویس استفاده نکنید.
برای آشنایی با مفهوم اهداف دسترسپذیری، بخش اهداف سطح سرویس در Google SRE Book منبع تکمیلی مناسبی است. این رویکرد یادآوری میکند که باید کیفیت از دید کاربران سنجیده شود، نه فقط سبزبودن سرورها.
معرفی Avaztek Monitoring برای دیدن سلامت سرور، شبکه و سرویسها در یکجا
Avaztek Monitoring برای پایش یکپارچه زیرساخت ساخته شده است. طبق مستندات محصول، این سامانه علاوه بر متریکهای منابع سرور مانند CPU و RAM، قابلیتهایی برای بررسی شبکه، Latency، HTTP، وضعیت SSL/TLS، پایش دیتابیس، رخدادهای خطا و Log Explorer ارائه میکند. این دادهها کمک میکنند وقتی کاربران از کندی یا قطعی میگویند، هم وضعیت داخلی سرور و هم بررسیهای سطح سرویس را کنار هم مشاهده کنید.
Agent سرور و بخشهای هشدار و گزارش امکان پیگیری روندها، دستهبندی سرورها و مشاهده رویدادها را فراهم میکنند. توجه داشته باشید که پشتیبانی از بررسی شبکه با تضمین مانیتورینگ همزمان از تمام کشورهای جهان یکسان نیست؛ اگر به چندموقعیتی واقعی نیاز دارید، محل اجرای Probe و پوشش جغرافیایی را برای نیاز خود بررسی کنید.
چطور از مانیتورینگ آواتک برای تشخیص خطای واقعی استفاده کنیم؟
- سرور اصلی را در سامانه معرفی و وضعیت Agent و سرویسهای حیاتی را بررسی کنید.
- مانیتورهای HTTP/شبکه و اعتبار SSL مرتبط با سرویس را فعال کنید.
- برای خطای مسیرهای مهم و تأخیر غیرعادی، هشدار مناسب تعریف کنید.
- هنگام Incident، زمان و نتیجه بررسی بیرونی را با متریکهای سرور، وضعیت دیتابیس و لاگها مقایسه کنید.
- پس از اصلاح، از همان مبدأها تست را تکرار کنید و روند موفقیت را مستند نگه دارید.
برای آشنایی بیشتر با امکانات و شرایط جاری، صفحه پلنهای رسمی را ببینید یا از ایجاد حساب کاربری برای شروع استفاده کنید. اگر هنوز در انتخاب متریکهای پایه تردید دارید، راهنمای جامع مانیتورینگ سرور نیز برای مرحله نخست مفید است.
سؤالات متداول درباره مانیتورینگ قطعی سایت و سرور
چرا Nginx پاسخ ۲۰۰ میدهد ولی سایت برای بعضی کاربران باز نمیشود؟
ممکن است درخواست در مسیر برگشت ناقص بماند، منابع CSS/JS دریافت نشوند، CDN یا شبکه منطقهای اختلال داشته باشد، یا مسیر دیگری مانند API خطا دهد. باید دریافت کامل پاسخ و تجربه واقعی کاربر از چند مسیر بررسی شود.
آیا Ping موفق یعنی سایت سالم است؟
خیر. Ping تنها وضعیت بخشی از ارتباط IP/ICMP را نشان میدهد. برای سرویس وب، اتصال HTTPS، محتوای موردانتظار و زمان دریافت پاسخ واقعی نیز باید بررسی شوند.
تفاوت Timeout شبکه با خطای ۵۰۲ چیست؟
۵۰۲ معمولاً پاسخ HTTP از یک Gateway یا Proxy است که با سرویس بالادستی مشکل دارد. Timeout یعنی اتصال یا دریافت پاسخ در زمان مجاز کامل نشده؛ علت میتواند شبکه یا کندی سرویس باشد. کد خطا، مرحله شکست و لاگها به تشخیص کمک میکنند.
چرا فقط کاربران خارج از ایران مشکل دارند؟
ممکن است مسیرهای بینالملل، سیاست فایروال، لایه CDN یا تنظیمات شبکه مقصد متفاوت باشند. بدون مقایسه مسیرهای واقعی، نمیتوان علت را با اطمینان مشخص کرد. تست چندنقطهای و Capture کنترلشده ارزشمندند.
آیا ابزار مانیتورینگ بهتنهایی جلوی قطعی را میگیرد؟
خیر. ابزار زودتر هشدار میدهد و داده تشخیصی فراهم میکند؛ رفع ریشه مشکل و طراحی افزونگی یا ظرفیت برعهده معماری و تیم عملیات است. بعضی واکنشهای خودکار نیز نیازمند تأیید و کنترل ریسکاند.
Avaztek Monitoring امکان بررسی SSL و شبکه دارد؟
بله؛ طبق مستندات فعلی، مانیتورینگ گواهی SSL/TLS و بررسی شبکه و سرویسها از بخشهای سامانه هستند. برای پوشش دقیق مقصدها و امکانات پلن موردنیاز، تنظیمات و شرایط محصول را بررسی کنید.
برای تکمیل تصویر عملیاتی، راهنمای هشدار هوشمند مانیتورینگ سرور نحوه کاهش پیامهای کاذب را توضیح میدهد و مقاله پیشبینی ظرفیت سرور به برنامهریزی منابع در برابر رشد ترافیک کمک میکند.
جمعبندی؛ مانیتورینگ سرور باید از چشم کاربر هم نگاه کند
سالمبودن پردازشها شرط لازم است، نه کافی. برای تشخیص قطعی واقعی، لایههای DNS، TCP، TLS، HTTP و دریافت کامل پاسخ را در کنار متریکهای داخلی و گزارش کاربران تحلیل کنید. با مانیتورینگ سرور از چند زاویه، میتوان اختلاف میان «Origin سالم» و «کاربر ناراضی» را سریعتر فهمید و جلوی عیبیابی عجولانه را گرفت. برای یک نمای یکپارچه از سلامت سرور، شبکه و سرویسها، سامانه مانیتورینگ آواتک را بررسی کنید.
نظرات و گفتوگو
نظرها پس از تایید مدیر منتشر میشوند. پاسخهای رسمی مدیر با نشان مشخص نمایش داده میشوند.