
مانیتورینگ سرور چیست؟ راهنمای جامع پایش، هشدار و عیبیابی
آموزش جامع مانیتورینگ سرور: بررسی CPU و RAM، سلامت وبسایت و دیتابیس، مانیتورینگ SSL، تنظیم هشدار و عیبیابی خطا؛ همراه با معرفی Avaztek Monitoring.
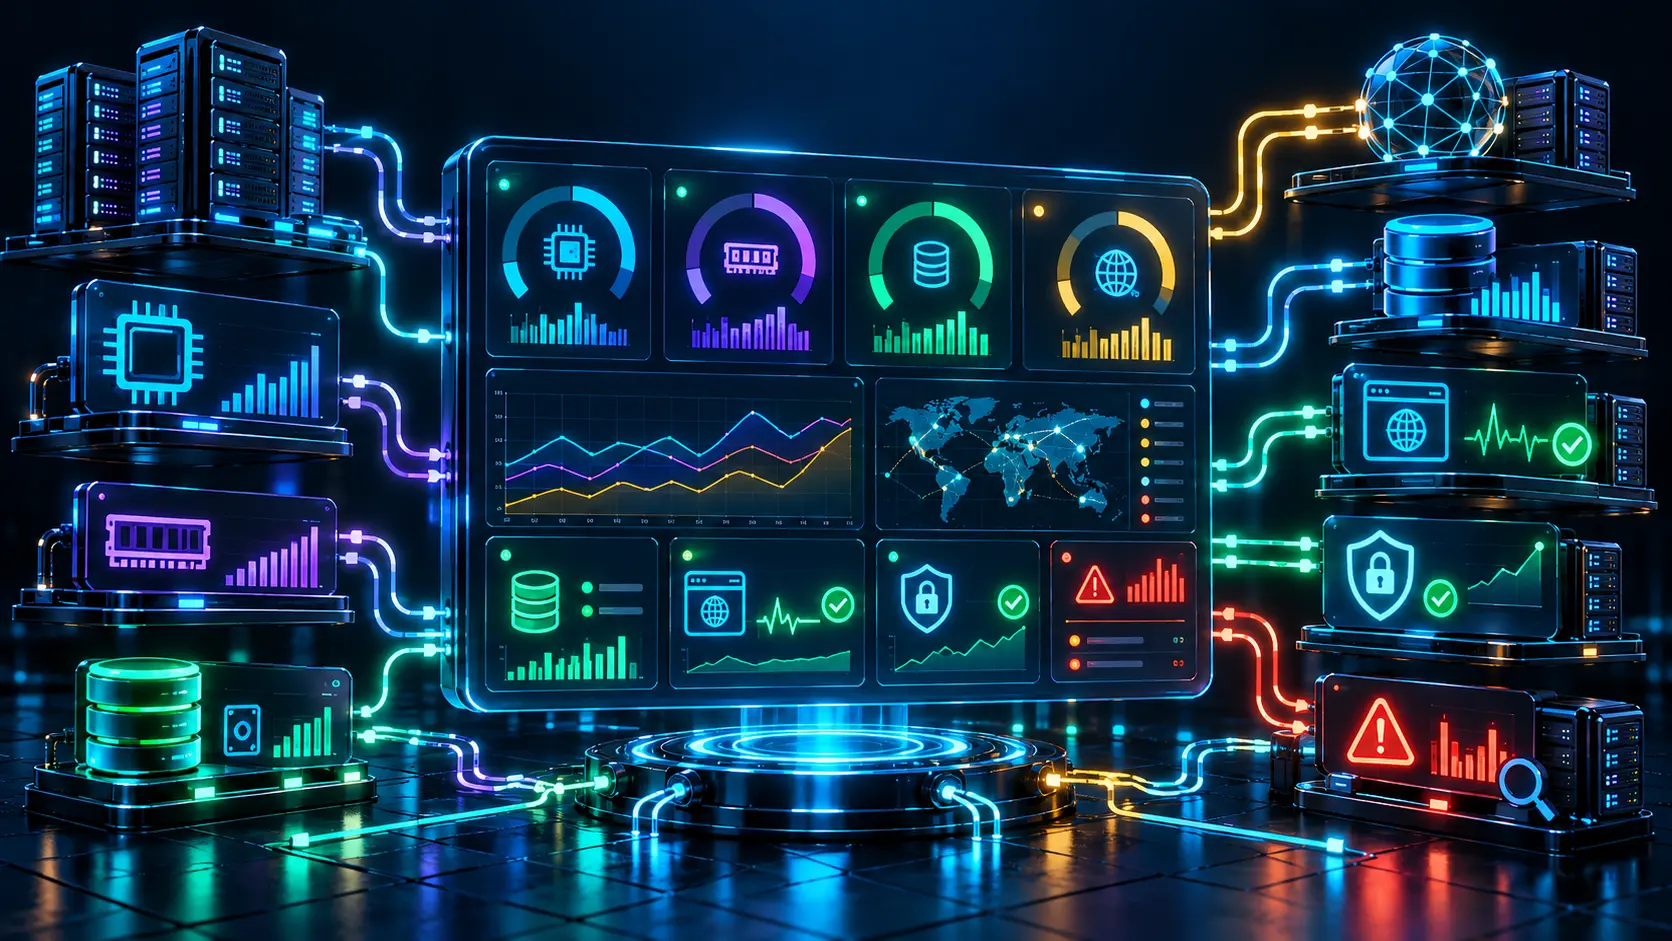
گاهی سایت از نظر کاربر باز نمیشود، درحالیکه سرویس Nginx روشن است. گاهی هم داشبورد سرور عدد CPU را بالا نشان میدهد، اما مشکل اصلی از دیسک، صف پردازش یا شبکه است. مانیتورینگ سرور یعنی بهجای حدسزدن، برای سلامت زیرساخت داده قابلاعتماد، روند تاریخی و هشدار قابلاقدام داشته باشیم؛ آن هم پیش از اینکه یک اختلال کوچک به قطعی گسترده تبدیل شود.
در این راهنمای کاربردی میبینیم چه شاخصهایی مهماند، چگونه مانیتورینگ را برای Linux، وبسرور، دیتابیس و شبکه راهاندازی کنیم، برای هشدارها چه آستانههایی انتخاب کنیم و چگونه با یک نقشه واکنش روشن، زمان تشخیص و رفع خطا را کاهش دهیم. در پایان نیز راهکاری یکپارچه از آوازتک برای شروع این مسیر معرفی میکنیم.
مانیتورینگ سرور چیست و چرا برای سایت ضروری است؟
مانیتورینگ سرور فرایند جمعآوری، ثبت و تحلیل مداوم وضعیت سرور و سرویسهای وابسته است؛ مثل مصرف پردازنده و حافظه، فضای ذخیرهسازی، سرعت پاسخ HTTP، خطاهای نرمافزار، در دسترس بودن دیتابیس و وضعیت اعتبار گواهی SSL. خروجی خوب فقط نمودار نیست: باید بتوان از روی دادهها تصمیم گرفت چه اتفاقی افتاده، از چه زمانی شروع شده و مسئول اقدام بعدی کیست.
برای یک وبسایت فروشگاهی، تأخیر پاسخ ممکن است به سفارش ناتمام تبدیل شود؛ برای یک API، افزایش خطا میتواند برنامههای متصل را مختل کند؛ و برای تیم عملیات، اطلاع دیرهنگام از کمبود فضای دیسک ممکن است به توقف سرویس برسد. اهمیت مانیتورینگ در اندازه کسبوکار خلاصه نمیشود؛ حتی یک سرور هم به پایش پایه نیاز دارد.
تفاوت مانیتورینگ با آپتایم و مشاهدهپذیری چیست؟
- Uptime Monitoring یا پایش دسترسپذیری: بررسی میکند وبسایت یا سرویس از بیرون پاسخ میدهد یا خیر.
- Infrastructure Monitoring: منابع و وضعیت سیستمعامل، پردازشها، پورتها، شبکه و ذخیرهسازی را زیر نظر میگیرد.
- Application Monitoring: خطا، زمان پاسخ، صفها و رفتار یک سرویس یا درخواست را تحلیل میکند.
- Observability یا مشاهدهپذیری: با کنار هم گذاشتن متریکها، لاگها و در صورت وجود ردگیری درخواستها، مسیر رسیدن به علت مشکل را کوتاهتر میکند.
فقط دریافت پاسخ ۲۰۰ از صفحه اصلی کافی نیست؛ ممکن است صفحه اصلی سالم باشد اما فرآیند پرداخت، بخش ورود، یک مسیر API یا صفحهای با منابع زیاد مشکل داشته باشد. از سوی دیگر، مصرف CPU بهتنهایی نشان نمیدهد کاربر نهایی چه تجربهای دارد. پایش مؤثر باید هر دو دید داخل سرور و خارج از سرور را پوشش دهد.
کدام شاخصهای مانیتورینگ سرور مهمترند؟
بهترین نقطه شروع، انتخاب مجموعهای کوچک از شاخصهای مرتبط با سرویس واقعی شماست. ثبت هزاران عدد بدون تعریف اینکه چه زمانی باید اقدام کرد، فقط نویز میسازد. جدول زیر یک نقشه اولیه است؛ آستانه مناسب هر زیرساخت باید با توجه به رفتار عادی و ظرفیت آن تنظیم شود.
| بخش | شاخص مهم | چه مشکلی را نشان میدهد؟ |
|---|---|---|
| CPU | مصرف، Load، زمان انتظار I/O و روند آنها | پردازش سنگین، صف اجرای کارها یا انتظار برای دیسک |
| RAM | حافظه در دسترس، Swap و نرخ خطاهای حافظه | فشار حافظه، افزایش Swap یا احتمال OOM |
| Disk | درصد اشغال، inode، سرعت و تأخیر خواندن/نوشتن | پرشدن فضا یا کندی ذخیرهسازی |
| Network | ترافیک، Packet Loss، خطا و Retransmission | اختلال مسیر یا کیفیت ارتباط |
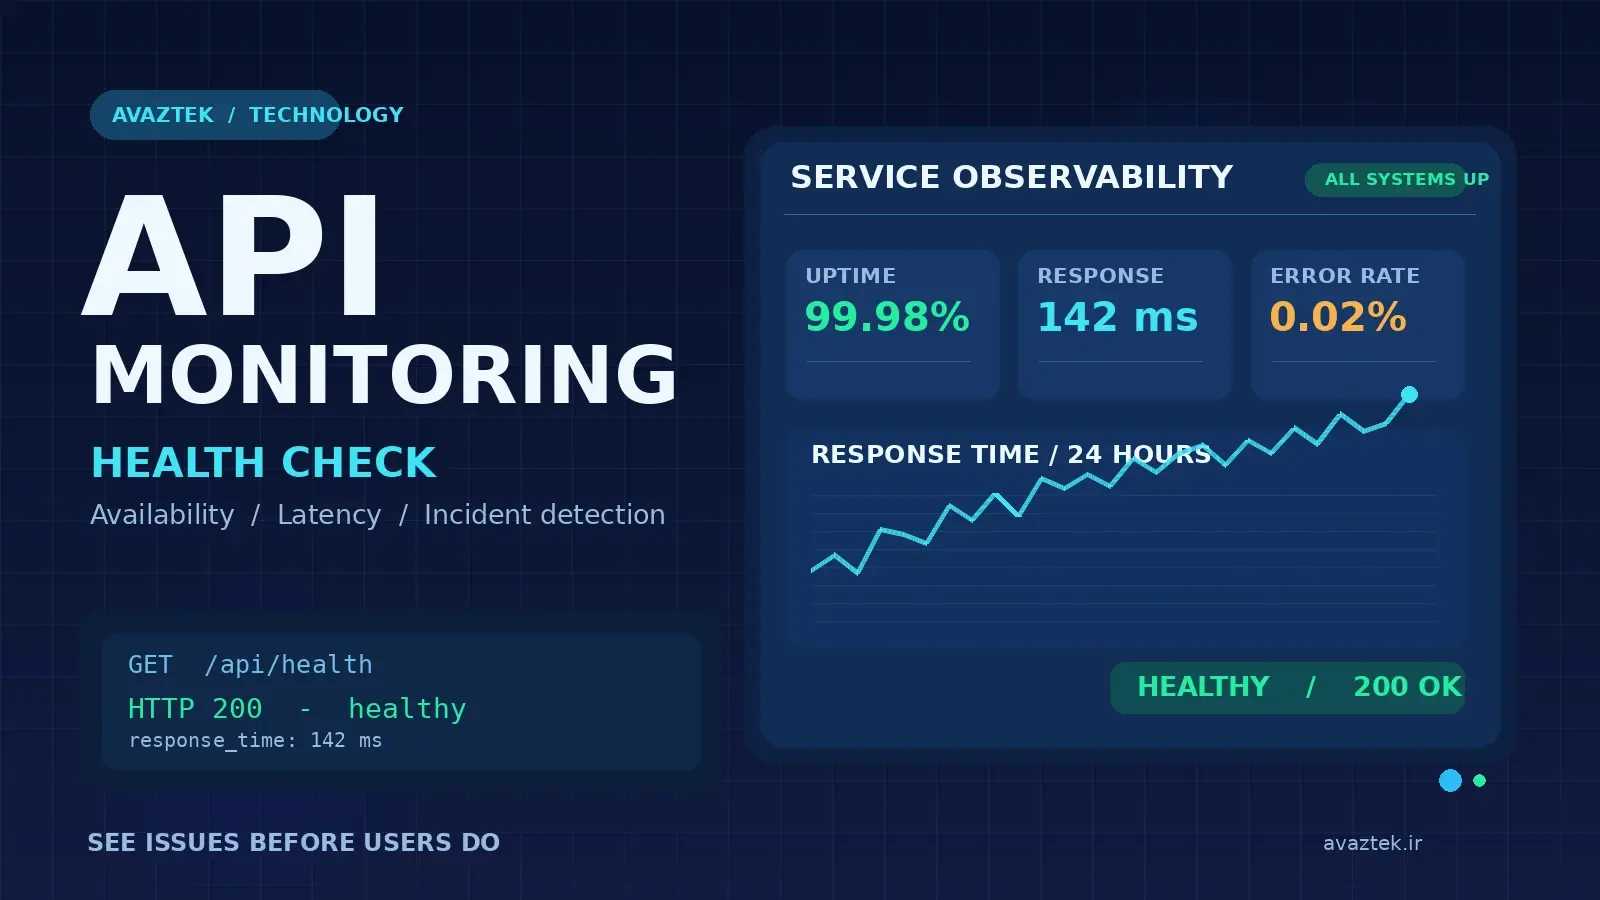
| HTTP / API | نرخ موفقیت، زمان پاسخ، p95 و خطاهای 5xx | کندی یا عدم دسترسی از دید کاربران |
| Database | سلامت اتصال، تأخیر کوئری و تعداد اتصالها | گلوگاه خواندن/نوشتن یا محدودیت اتصال |
| SSL / Domain | اعتبار و زمان باقیمانده گواهی | ریسک قطع اتصال امن به دلیل انقضا یا پیکربندی |
چرا Load Average همان درصد CPU نیست؟
Load Average تعداد متوسط کارهای درحال اجرا یا منتظر اجرا را در بازههای زمانی نشان میدهد؛ این عدد «درصد» نیست. مثلاً Load برابر ۸ روی یک سرور ۸ هستهای با همان عدد روی سرور دو هستهای معنای یکسانی ندارد. برای تشخیص درست، Load را در کنار مصرف هر هسته، iowait، وضعیت پردازشها و محدودیت CPU کانتینر یا ماشین مجازی بررسی کنید.
چرا تنها نگاهکردن به RAM Used گمراهکننده است؟
لینوکس از بخشی از RAM برای کش فایلها استفاده میکند و این حافظه در شرایط لازم قابل آزادسازی است. به همین دلیل، Available Memory، افزایش Swap، رخدادهای OOM و رفتار برنامه در زمان فشار معمولاً سرنخ بهتری نسبت به درصد خام حافظه مصرفشده هستند.
چهار سیگنال طلایی در مانیتورینگ سرویس
برای برنامههای تحت وب، چهار مفهوم کاربردی عبارتاند از Latency (تأخیر پاسخ)، Traffic (حجم درخواستها)، Errors (خطاها) و Saturation (نزدیکشدن منابع به ظرفیت). با ترکیب این چهار سیگنال میتوان فهمید مشکل فقط افزایش ترافیک است یا کیفیت پاسخ به کاربر هم افت کرده است.
برای مثال، اگر تعداد درخواستها دو برابر شود اما زمان پاسخ و خطا ثابت بماند، لزوماً بحران نداریم. ولی اگر p95 زمان پاسخ همزمان بالا برود، خطای ۵۰۲ زیاد شود و صف درخواستها رشد کند، باید ظرفیت وبسرور، PHP-FPM، دیتابیس یا سرویسهای وابسته را بررسی کنیم.
شاخصهای SLI، SLO و بودجه خطا
SLI روشی برای اندازهگیری کیفیت واقعی سرویس است، مثل «درصد درخواستهایی که با پاسخ موفق و در زمان قابلقبول انجام شدهاند». SLO هدف مورد توافق برای همان شاخص است؛ مثلاً دسترسپذیری ۹۹٫۹ درصد در ماه. این هدف در ماه ۳۰روزه تقریباً معادل ۴۳٫۲ دقیقه بودجه عدم دسترسی است. این عدد هدف طراحی است، نه تضمین فنی هیچ ابزار مانیتورینگی.
اگر سامانهای حیاتیتر است، هدفش باید با تجربه کاربر، قرارداد خدمات، ظرفیت تیم و هزینه عملیاتی همخوان باشد. پیشنهاد میشود دستکم یک SLI مربوط به تجربه کاربر و یک شاخص سلامت زیرساخت انتخاب شود.
مانیتورینگ از بیرون و داخل سرور را با هم ترکیب کنید
بررسی بیرونی: HTTP، TCP، ICMP و SSL
یک چک HTTP باید علاوه بر برقراری اتصال، کد پاسخ، زمان دریافت اولین بایت و در صورت نیاز محتوای مورد انتظار را ارزیابی کند. برای صفحه ورود یا یک API حیاتی، بهتر است مسیر واقعی همان سرویس بررسی شود و صرفاً تست صفحه اصلی معیار سلامت نباشد. بررسی TCP به بازبودن مسیر یک پورت کمک میکند، اما بهتنهایی به معنای سالمبودن برنامه نیست. ICMP نیز فقط بخشی از وضعیت دسترسی شبکه را نشان میدهد و در برخی شبکهها ممکن است محدود شود.
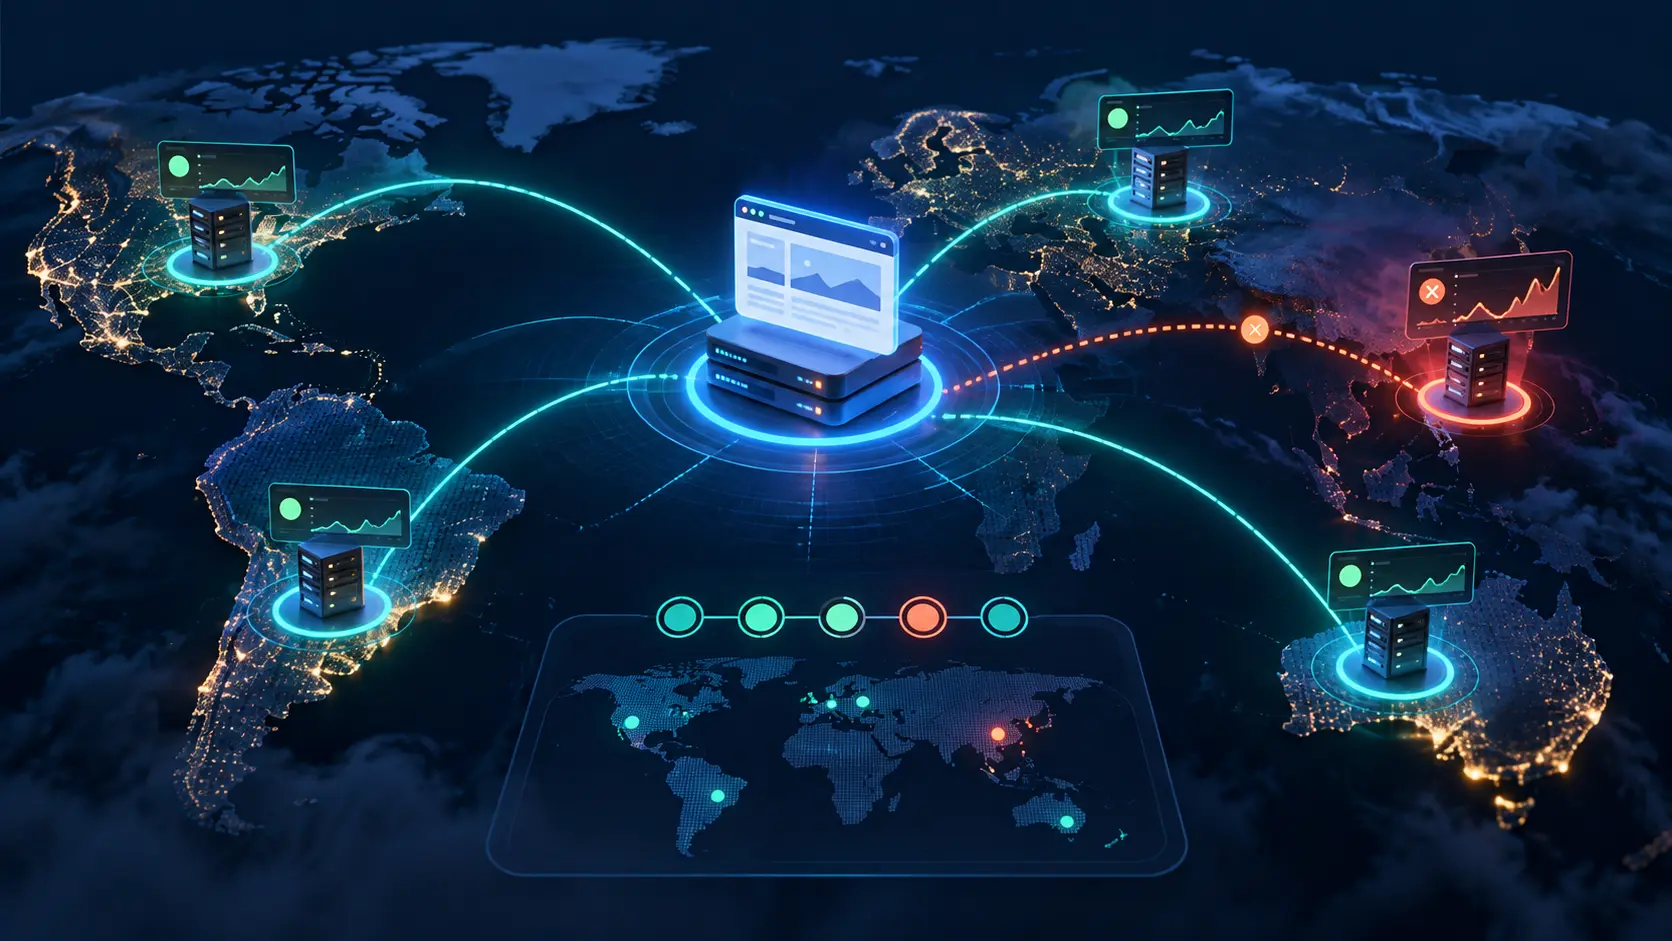
گواهی SSL/TLS را جداگانه زیر نظر بگیرید: اعتبار گواهی، دامنه صحیح، زمان باقیمانده تا انقضا و نتیجه اتصال امن. اگر مانیتور از چند شبکه یا موقعیت اجرا میشود، اختلاف نتیجهها را بهعنوان نشانهای برای بررسی مسیریابی یا سیاستهای امنیتی در نظر بگیرید؛ یک Timeout خارجی لزوماً خرابی کد وبسایت نیست.
بررسی داخلی: Agent، سرویسها، لاگها و دیتابیس
Agent سبکوزن روی سرور میتواند دادههایی را ثبت کند که از بیرون دیده نمیشوند: مصرف واقعی هر منبع، سرویسهای متوقفشده، فشار روی شبکه، وضعیت پردازشها و بخشی از رخدادهای سیستمی. برای دیتابیس نیز سالمبودن اتصال، تعداد نشستهای فعال، زمان کوئریهای کند و محدودیت ظرفیت اهمیت دارد. پیش از فعالکردن جمعآوری لاگ، مشخص کنید چه دادههایی حساساند و چه مدت باید نگهداری شوند.
آموزش راهاندازی مانیتورینگ سرور در ۷ گام
- فهرست داراییها: سرورها، دامنهها، سرویسهای وب، دیتابیسها، پورتهای حیاتی و مالک هر سرویس را ثبت کنید. برای هر مورد مشخص کنید قطعشدنش چه پیامدی دارد.
- تعریف یک هدف قابلاندازهگیری: مثلاً موفقیت درخواستهای صفحه خرید، تأخیر p95 یک API یا در دسترس بودن دیتابیس. از «همهچیز سبز باشد» بهعنوان هدف اصلی استفاده نکنید.
- نصب Agent یا اتصال دادهها: بر اساس مدل ابزار انتخابی، Agent مورداعتماد نصب کنید و اتصال آن به داشبورد را با حداقل دسترسی لازم بررسی کنید.
- ساخت مانیتورهای بیرونی: HTTP/HTTPS، پورتهای مهم، SSL و در صورت نیاز ICMP را برای مسیرهایی فعال کنید که واقعاً برای کاربر حیاتیاند.
- شناخت خط پایه (Baseline): رفتار عادی روزهای کمترافیک و پرترافیک را ثبت کنید تا جهش واقعی از نوسان بیخطر قابلتشخیص شود.
- تنظیم هشدار و مسیر اطلاعرسانی: شدت مشکل، تداوم وضعیت، کانال دریافت هشدار، مسئول رسیدگی و پیام بازیابی (Recovery) را تعریف کنید.
- آزمایش و بازبینی: یک سناریوی بیخطر و کنترلشده را اجرا کنید، رسیدن هشدار را بسنجید و آستانههای نامناسب را پس از مشاهده رفتار واقعی اصلاح کنید.
برای تیمهای کوچک بهتر است از چند مانیتور پرارزش شروع کرد: سلامت صفحه اصلی و مسیر ورود، فضای دیسک، فشار حافظه، وضعیت دیتابیس و انقضای SSL. پس از اطمینان از کیفیت هشدارها میتوان پوشش را به صفها، APIهای فرعی و سنجش تجربه کاربر گسترش داد.
آستانه هشدار را چگونه تنظیم کنیم تا پیام بیهوده نگیریم؟
هشدار خوب باید قابل اقدام، اولویتدار و همراه با زمینه باشد. اینکه CPU یک ثانیه به ۹۰ درصد برسد، بهتنهایی دلیل بیدارکردن تیم عملیات نیست. ترکیب شدت و مدتزمان وقوع، وضعیت سرویس و روند قبلی معمولاً نتیجه دقیقتری میدهد.
| سناریو | مثال آستانه اولیه | اقدام پیشنهادی |
|---|---|---|
| مصرف CPU بالا | بیش از ۸۵٪ به مدت ۵ دقیقه | بررسی فرایندهای سنگین و مقایسه با ترافیک |
| فضای دیسک در خطر | بیش از ۸۵٪ یا رشد سریع حجم لاگ | بررسی روند اشغال و ظرفیت آزاد واقعی |
| حافظه کم | Available پایین همراه با رشد Swap | بررسی فشار حافظه و پردازشهای درحال رشد |
| خطای وب | رشد مداوم پاسخهای 5xx و افت نرخ موفقیت | تطبیق با لاگ برنامه، PHP-FPM و دیتابیس |
| انقضای SSL | اخطار زودهنگام و تکرار نزدیک تاریخ انقضا | بررسی تمدید گواهی و زنجیره اعتماد |
توجه: این اعداد مثال آموزشی هستند، نه استاندارد جهانی. برای سرویس پرترافیک، سرور کوچک، پردازش batch یا دیسکی که سریع پر میشود، آستانهها باید متفاوت باشند. اخطار CPU را با وضعیت زمان پاسخ یا صف پردازش تکمیل کنید و برای کاهش هشدار کاذب، از مدتزمان تداوم و Cooldown استفاده کنید.
سطحبندی هشدارها: اطلاعرسانی، هشدار و بحران
اطلاعرسانی برای روندهایی است که نیازمند اقدام فوری نیستند؛ هشدار زمانی است که یک شاخص به محدوده نگرانکننده نزدیک میشود؛ و بحران برای قطعی واقعی یا تهدید فوری تجربه کاربر به کار میرود. بهتر است هر هشدار شامل نام سرور، نام سرویس، زمان شروع، مقدار شاخص، لینک داشبورد و دستورالعمل کوتاه بررسی باشد. پیام بازگشت سرویس به وضعیت عادی نیز از انباشت هشدارهای نامشخص جلوگیری میکند.
وقتی هشدار آمد، چه چیزهایی را بررسی کنیم؟
مانیتورینگ جایگزین عیبیابی نیست؛ اما ترتیب رسیدن به علت را روشن میکند. قبل از ریاستارت عجولانه، وضعیت فعلی را ثبت کنید، تغییرات اخیر را بررسی کنید و بدانید اقدام شما چه تأثیری بر کاربران دارد. برای مثال:
سناریوی اول: سایت خطای ۵۰۲ یا ۵۰۳ میدهد
زمان شروع خطا، تعداد درخواستها و وضعیت سرویسهای جلویی مانند Nginx یا Apache را ثبت کنید. سپس وضعیت PHP-FPM یا پردازش برنامه، تعداد اتصالهای دیتابیس و صفهای پسزمینه را با هم ببینید. اگر وبسرور پاسخ میدهد اما سرویس بالادستی از دسترس خارج است، افزایش منابع بدون شناخت علت ممکن است فقط مشکل را پنهان کند. برای مشاهده الگوی خطا و زمان وقوع به لاگهای وبسرور و برنامه مراجعه کنید.
سناریوی دوم: CPU برای چند ثانیه به ۱۰۰٪ میرسد
ابتدا مشخص کنید افزایش مصرف پایدار است یا به کارهای زمانبندیشده مربوط میشود. در Linux، خروجی top یا htop را با زمان اجرای Cron، Jobهای صف و نمودار CPU تطبیق دهید. اگر مصرف کوتاه و برنامهریزیشده است، بهجای افزایش فوری ظرفیت، همزمانی وظایف را مدیریت کنید. اگر تأخیر درخواست کاربران نیز بیشتر شده، آن وقت ظرفیت و طراحی پردازش نیازمند بررسی جدیتر است.
سناریوی سوم: دیسک یا دیتابیس رو به پرشدن است
فقط درصد فضای دیسک را نبینید؛ نرخ رشد لاگ، فایلهای موقت، پشتیبانها و inodeها مهماند. حذف کورکورانه فایلهای لاگ یا نسخههای پشتیبان در سرور عملیاتی خطرناک است. ابتدا مسیرهای پرمصرف، سیاست نگهداری و امکان چرخش لاگها را شناسایی کنید. برای دیتابیس نیز فضای ذخیرهسازی را در کنار رشد جدولها و تأخیر کوئریها بررسی کنید.
سناریوی چهارم: از خارج کشور Timeout میبینید
ممکن است یک سایت روی خود سرور پاسخ HTTP ۲۰۰ بدهد، اما کاربران برخی شبکهها با Timeout روبهرو شوند. در این حالت سلامت Nginx تنها یک قطعه از پازل است. زمان اتصال TCP، تکمیل TLS، دریافت اولین بایت، دریافت کامل پاسخ و تعداد بازفرستادن بستهها را جداگانه بررسی کنید. نتیجه مانیتورهای چندموقعیتی، وضعیت Firewall و تجهیزات شبکه باید کنار هم تفسیر شود. برای فهم لایههای ریسک بیشتر، مطلب ریسکهای امنیتی هوش مصنوعی و راهکارها را هم ببینید.
چند دستور خواندنی برای بررسی اولیه Linux
uptime
free -h
df -h
df -i
ss -s
journalctl -p warning --since "30 minutes ago"
این دستورات برای مشاهده اولیه مفیدند، اما خروجی هرکدام باید با ساختار سیستم تفسیر شود؛ مثلاً روی سرور کانتینری، محدودیت CPU یا RAM کانتینر نیز باید بررسی شود. دستورهای تعمیر یا پاکسازی را صرفاً بر اساس یک عدد اجرا نکنید.
اشتباهات رایج در طراحی مانیتورینگ
- فقط مانیتورکردن صفحه اصلی: مسیرهای حیاتی مانند ورود، پرداخت و APIها ممکن است جداگانه خراب شوند.
- هشدار برای هر تغییر کوچک: پیامهای فراوان و بیاهمیت باعث میشوند هشدار بحرانی هم نادیده گرفته شود.
- توجه به میانگین و بیتوجهی به p95: ممکن است بخش کوچکی از کاربران تأخیر آزاردهندهای تجربه کنند، ولی میانگین طبیعی باشد.
- نداشتن مسئول مشخص: ارسال پیام به چند نفر بدون تعیین مسئول رسیدگی، زمان رفع مشکل را بیشتر میکند.
- نداشتن تاریخچه: مشاهده عدد لحظهای بدون دانستن وضعیت پیش از اختلال، علتیابی را سخت میکند.
- نادیدهگرفتن کیفیت مسیر شبکه: بازبودن TCP یا پاسخدادن از داخل سرور به معنای دریافت کامل پاسخ در تمام شبکهها نیست.
- دسترسی بیشازحد Agent: جمعآوری داده باید با حداقل مجوز، ارتباط امن و مدیریت چرخه عمر کلیدها انجام شود.
امنیت سامانه مانیتورینگ بهاندازه عملکرد آن مهم است
داشبورد مانیتورینگ میتواند اطلاعات حساسی درباره IP، ساختار شبکه، نام سرویسها و رخدادهای عملیاتی در اختیار داشته باشد. بهتر است دسترسی بر اساس نقش تقسیم شود، MFA برای حسابهای حساس فعال باشد، کانال ارتباط با Agent امن باشد و رویدادهای مدیریتی ثبت شوند. دادههای حساس مانند رمز عبور، توکن دسترسی یا اطلاعات شخصی نباید بیدلیل وارد لاگها شوند.
نسخههای پشتیبان تنظیمات مانیتورینگ، سیاست نگهداری دادهها، نظارت بر خود سامانه مانیتورینگ و آزمایش هشدار از موضوعاتیاند که نباید فراموش شوند. برای زیرساختهای حساس، بررسی از چند نقطه مستقل میتواند احتمال «مانیتورینگ کور» را کاهش دهد؛ البته خود این نقاط نیز ممکن است با محدودیت شبکه روبهرو باشند.
معرفی Avaztek Monitoring؛ پایش سرور و سرویسها در یک داشبورد
پس از شناخت شاخصها، چالش بعدی انتخاب ابزاری است که این دادههای پراکنده را قابلاستفاده کند. Avaztek Monitoring، سامانه مانیتورینگ آوازتک برای پایش یکپارچه سلامت سرورها، سرویسها و زیرساخت طراحی شده است. هدف آن این است که تیم بهجای سرزدن به چند پنل و خواندن چند فایل لاگ، تصویر روشنتری از سلامت سرویسها و رخدادهای مرتبط داشته باشد.
طبق قابلیتهای اعلامشده در وبسایت و مستندات همین سامانه، امکان بررسی منابع CPU، RAM، Disk و شبکه، وضعیت سرویسها، بررسیهای HTTP، TCP و ICMP، پایش SSL/TLS و دیتابیس، مشاهده روندها، مدیریت هشدار و کار با لاگها فراهم است. هشدارها میتوانند با آستانه و کانال اطلاعرسانی مناسب تنظیم شوند؛ دسترسپذیری هر قابلیت ممکن است به تنظیمات، نوع سرویس و پلن انتخابی وابسته باشد.
مانیتورینگ آوازتک برای چه کسانی مناسب است؟
- مدیر سرور یا وبسایت که میخواهد پیش از پرشدن دیسک یا انقضای SSL هشدار دریافت کند.
- تیم توسعهای که به ارتباط میان خطاهای HTTP، وضعیت دیتابیس و فشار منابع نیاز دارد.
- مسئول زیرساختی که چند سرور، سرویس یا دامنه را از یک محیط مدیریت میکند.
- کسبوکاری که بهدنبال راهاندازی تدریجی پایش، بدون پراکندگی ابزارهای متعدد است.
شروع کار با سامانه Avaztek Monitoring
- به وبسایت رسمی Avaztek Monitoring مراجعه کنید.
- از مسیر ایجاد حساب کاربری شروع کنید و امکانات هر پلن را در صفحه پلنها بررسی کنید.
- سرور یا سرویس موردنظر را اضافه کنید و مطابق راهنمای پنل، Agent را در صورت نیاز نصب نمایید.
- مانیتورهای منابع، HTTP و SSL را فعال کنید و دریافت هشدار آزمایشی را بررسی کنید.
- پس از ثبت رفتار عادی سرویس، آستانهها و مسئول رسیدگی را تنظیم کنید.
وبسایت محصول امکان شروع با حساب رایگان را معرفی میکند، اما برای اطلاع از محدودیتها، ظرفیتها و قیمت روز، به همان صفحه پلنهای رسمی مراجعه کنید؛ این راهنما وعده آپتایم قطعی یا رفع خودکار اختلال نمیدهد.
چکلیست نهایی مانیتورینگ سرور پیش از بهرهبرداری
- فهرست سرورها، سرویسها و مالکان آنها تهیه شده است.
- حداقل یک مانیتور دسترسپذیری بیرونی و یک منبع متریک داخلی فعال است.
- CPU، حافظه در دسترس، دیسک، شبکه و وضعیت سرویسهای حیاتی دیده میشوند.
- صفحهها یا APIهای مهم بهصورت مستقل بررسی میشوند.
- اعتبار SSL و زمان انقضای آن رصد میشود.
- اتصال دیتابیس و روند کندیها ارزیابی میشود.
- هشدارها سطحبندی، زمان تداوم و پیام بازیابی دارند.
- مسئول رسیدگی و دستورالعمل کوتاه هر حادثه مشخص است.
- دسترسیهای داشبورد و Agent حداقلی و امن هستند.
- هشدار آزمایشی اجرا شده و در فاصلههای منظم بازبینی میشود.
سؤالات متداول درباره مانیتورینگ سرور
مانیتورینگ سرور چیست؟
مانیتورینگ سرور یعنی جمعآوری و تحلیل پیوسته شاخصهایی مانند مصرف CPU، حافظه، دیسک، وضعیت سرویسها و شبکه، همراه با هشدار زمانی که مشکل مهمی دیده میشود. هدف اصلی، تشخیص سریعتر و اقدام آگاهانهتر است.
آیا مانیتورینگ سرور سرعت سایت را افزایش میدهد؟
خود ابزار مانیتورینگ الزاماً سایت را سریعتر نمیکند؛ اما نشان میدهد کجا تأخیر، مصرف منابع یا خطا افزایش یافته تا اصلاح متناسب با علت انجام شود. نصب هر Agent نیز مصرف منابع مشخصی دارد که باید کنترل شود.
برای مانیتورینگ یک VPS کوچک از کجا شروع کنیم؟
با سلامت HTTP سرویس اصلی، CPU، حافظه در دسترس، فضای دیسک، اعتبار SSL و یک کانال هشدار شروع کنید. پس از ثبت چند روز داده، شاخصهای تکمیلی مانند دیتابیس، صف و زمان پاسخ API را اضافه کنید.
هر چند دقیقه یک بار سلامت سرور را بررسی کنیم؟
پاسخ ثابت برای همه سرویسها وجود ندارد. فاصله بررسی به حساسیت سرویس، هزینه هر نمونهبرداری و سرعت تغییر شاخصها بستگی دارد. شاخصهای حیاتی معمولاً به بازههای کوتاهتر نیاز دارند؛ دادههای ظرفیت و گزارشهای بلندمدت میتوانند کمتکرارتر باشند.
آیا فقط پینگگرفتن برای تشخیص آپتایم کافی است؟
خیر. پینگ فقط وضعیت بخشی از دسترسی شبکه را میسنجد و ممکن است به دلایل امنیتی محدود باشد. برای وبسایت بهتر است درخواست واقعی HTTPS، کد پاسخ، زمان پاسخ و در صورت نیاز محتوای صفحه هم بررسی شود.
تفاوت مانیتورینگ بدون Agent و با Agent چیست؟
روش بدون Agent معمولاً از بیرون دسترسی HTTP، TCP، ICMP یا SSL را بررسی میکند. Agent نصبشده روی میزبان امکان مشاهده شاخصهای داخلی، برخی سرویسها و دادههای سیستمی را فراهم میکند. بهترین انتخاب به نیاز، سیاست امنیتی و نوع زیرساخت بستگی دارد.
هشدارهای مانیتورینگ را چگونه از پیامهای بیاهمیت جدا کنیم؟
آستانه را با خط پایه سیستم تنظیم کنید، برای تداوم مشکل حداقل زمان قرار دهید، شدت و مسئول هر هشدار را مشخص کنید و پیام Recovery را فعال کنید. هشدار باید مشخص کند کدام سرویس مشکل دارد و چه اقدامی لازم است.
سامانه مانیتورینگ آوازتک را از کجا امتحان کنیم؟
از وبسایت monitoring.avaztek.ir وارد شوید، پلنها را بررسی کنید و از ثبتنام برای شروع استفاده کنید.
جمعبندی: از هشدار خام تا تصمیم درست
مانیتورینگ حرفهای با نصب یک داشبورد تمام نمیشود. ابتدا سرویس حیاتی را بشناسید، شاخصهای مفید را انتخاب کنید، از داخل و بیرون داده بگیرید، هشدار را بر اساس تجربه واقعی تنظیم کنید و هنگام حادثه روند بررسی مشخص داشته باشید. در این صورت، بهجای تصمیمگیری با حدس یا واکنش عجولانه، از اطلاعات قابلاتکا برای عیبیابی، ظرفیتسنجی و پیشگیری از تکرار خطا استفاده میکنید.
اگر بهدنبال جمعکردن پایش منابع، شبکه، دیتابیس، گواهی SSL و هشدارهای زیرساخت در یک داشبورد هستید، سامانه مانیتورینگ آوازتک نقطه شروع مناسبی برای ارزیابی است. امکانات و شرایط پلن مناسب زیرساخت خود را بررسی کنید و پایش را از چند سرویس واقعاً مهم آغاز کنید.
نظرات و گفتوگو
نظرها پس از تایید مدیر منتشر میشوند. پاسخهای رسمی مدیر با نشان مشخص نمایش داده میشوند.