
مانیتورینگ API چیست؟ آموزش Health Check و تشخیص اختلال سرویسها
اگر API از کار بیفتد اما سایت باز بماند، چه کسی باخبر میشود؟ راهنمای عملی مانیتورینگ API، طراحی Health Check، تشخیص Timeout و خطاهای سرویس، تنظیم هشدار و شروع رایگان با مانیتورینگ آوازتک.
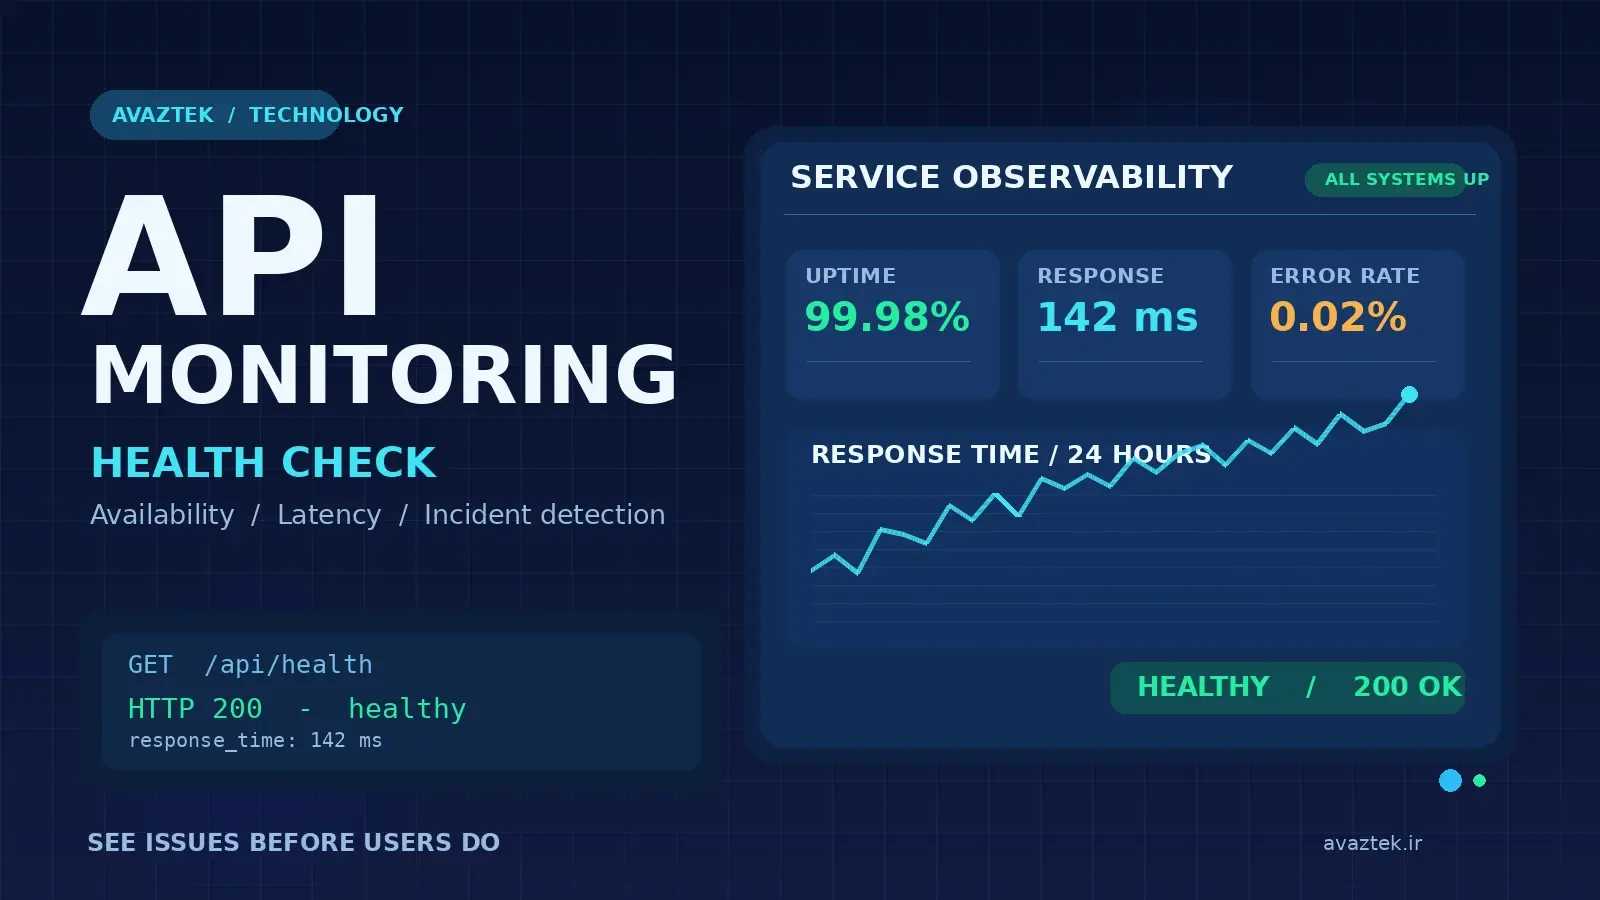
تصور کنید صبح شنبه، سفارشها در فروشگاه ثبت میشوند، اما پیام تأیید برای هیچکس نمیآید. سرور روشن است، صفحه اصلی باز میشود و حتی داشبورد CPU هم عدد نگرانکنندهای نشان نمیدهد. چند ساعت بعد معلوم میشود API ارسال پیامک از ابتدای روز خطا میداده است. اگر کسی فقط صفحه اصلی سایت را کنترل کرده باشد، این اختلال از چشمش پنهان میماند. مانیتورینگ API برای همین لحظههاست: زمانی که باید بدانیم یک سرویس واقعاً کار میکند یا فقط از بیرون زنده به نظر میرسد.
در این راهنما از تعریفهای خشک عبور میکنیم و سراغ چیزی میرویم که به کار مدیر سرور، برنامهنویس بکاند و صاحب کسبوکار میآید: Health Check چطور طراحی میشود، کدام خطاها نشانه اختلالاند، زمان پاسخ را چگونه تفسیر کنیم و چه وقت هشدار ارزش بیدارکردن تیم را دارد. در پایان هم مسیری عملی برای شروع پایش با مانیتورینگ آوازتک و بررسی پلن رایگان مانیتورینگ خواهید داشت.
مانیتورینگ API چیست و چه مشکلی را حل میکند؟
API رابطی است که دو نرمافزار از طریق آن با هم حرف میزنند؛ مثلاً اپلیکیشن موبایل برای ورود کاربر به سرور درخواست میفرستد، فروشگاه برای پرداخت سراغ درگاه میرود یا پنل مدیریت دادهها را از سرویس دیگری میخواند. مانیتورینگ API یعنی وضعیت این مسیرهای ارتباطی را بهصورت تکرارشونده اندازه بگیریم تا پیش از آنکه شکایت کاربران به دستمان برسد، نشانههای قطعی، کندی و پاسخ غیرمنتظره را ببینیم.
در سادهترین شکل، یک سامانه پایش در بازههای مشخص به نشانی API درخواست میفرستد و نتیجه را ثبت میکند: آیا اتصال برقرار شد؟ کد HTTP چه بود؟ پاسخ چقدر طول کشید؟ نتیجه با انتظار ما سازگار بود؟ ابزارهای پیشرفتهتر ممکن است بدنه پاسخ، گواهی SSL یا مراحل یک سناریوی چنددرخواستی را هم بررسی کنند. همه این قابلیتها در تمام ابزارها وجود ندارند؛ هنگام انتخاب سرویس باید مستندات همان محصول را مبنا قرار داد.
فایده اصلی، فقط یک چراغ سبز یا قرمز نیست. وقتی در ساعت ۱۰:۲۳ پاسخهای یک API کند میشوند و دو دقیقه بعد خطای ۵۰۳ افزایش پیدا میکند، تاریخچه پایش برای شروع عیبیابی ارزش دارد. بدون آن، تیم معمولاً باید از روی گزارشهای پراکنده حدس بزند اختلال از کجا آغاز شده است.
یک API میتواند آنلاین باشد اما درست کار نکند
فرض کنیم آدرس /api/orders کد 200 OK برمیگرداند. خبر خوبی است، اما هنوز نمیدانیم سفارشها واقعاً بازیابی شدهاند یا خیر. شاید بدنه پاسخ خالی باشد، اطلاعات مربوط به ساعت قبل باشد یا فقط بخشی از دادهها برگردد. در مقابل، کد 401 روی مسیر محافظتشدهای که بدون توکن فراخوانی شده، الزاماً اختلال نیست؛ رفتار مورد انتظار همان مسیر میتواند ردکردن درخواست ناشناس باشد.
پس قبل از ساخت مانیتور، یک سؤال کلیدی بپرسید: «برای این endpoint، پاسخ سالم دقیقاً چه معنایی دارد؟» برای صفحه ورود ممکن است وضعیت سرویس احراز هویت مهم باشد، برای API قیمتها تازگی داده و برای درگاه پرداخت قابلیت انجام تراکنش آزمایشیِ امن. تعریف سلامت باید به کارکرد واقعی همان سرویس نزدیک باشد، نه صرفاً به بازبودن پورت.
Health Check چیست؟ فرق Liveness و Readiness را بفهمیم
Health Check یک بررسی مشخص و کمهزینه برای پاسخ به پرسش «سرویس در چه وضعیتی است؟» است. بسیاری از برنامهها مسیری مانند /health یا /status دارند که بدون اجرای یک عملیات تجاری حساس، اطلاعات محدودی از سلامت سیستم برمیگرداند. این نقطه بهتر است سریع، قابلپیشبینی و بدون افشای جزئیات محرمانه باشد.
در معماریهای جدید، دو نوع بررسی را از هم جدا میکنند. Liveness میپرسد آیا خود فرایند برنامه زنده و پاسخگوست؟ Readiness میپرسد آیا برنامه در همین لحظه برای دریافت ترافیک واقعی آماده است؟ ممکن است فرایند زنده باشد، اما اتصال ضروری به دیتابیس برقرار نباشد؛ در این وضعیت Readiness شکست میخورد، درحالیکه Liveness هنوز موفق است.
این تفکیک بهخصوص در محیطهایی مثل Kubernetes اهمیت دارد. شکست Readiness میتواند باعث شود موقتاً ترافیک به نمونه ناسالم هدایت نشود، ولی استفاده نادرست از Liveness ممکن است برنامهای را که فقط منتظر سرویس وابسته است بیدلیل بارها راهاندازی مجدد کند. بنابراین بهتر است هر دو را با شناخت وابستگیهای واقعی برنامه طراحی کنید.
یک Health Check استاندارد چه پاسخی باید بدهد؟
فرض کنید یک سرویس سفارش دارید که بدون دیتابیس عملاً کاری انجام نمیدهد. مسیر آمادگی آن میتواند نتیجهای شبیه نمونه زیر برگرداند؛ این کد نمونه آموزشی است، نه قراردادی که تمام APIها باید عیناً رعایت کنند:
{
  "status": "healthy",
  "checks": {
    "database": "up",
    "cache": "up"
  },
  "timestamp": "2026-10-19T08:30:00Z"
}
در حالت سالم، وضعیت HTTP معمولاً در محدوده موفقیت است. اگر وابستگی ضروری از کار بیفتد، میتوان برای Readiness کد 503 Service Unavailable برگرداند تا سامانههای پایش یا توزیع بار مسئله را تشخیص دهند. اما مراقب باشید: در خروجی عمومی نباید رمز دیتابیس، رشته اتصال، آدرس خصوصی سرویسها، توکن یا گزارش خطای کامل را منتشر کرد. برای ناظر بیرونی معمولاً یک وضعیت حداقلی کافی است؛ جزئیات فنی را در لاگ و ابزار داخلی نگه دارید.
Health Check بهتر است از نوشتن داده در دیتابیس، ایجاد تراکنش پرداخت، ارسال پیامک واقعی یا پردازش سنگین خودداری کند. این بررسی قرار است درباره سلامت خبر بدهد، نه اینکه خودش باعث بار و اختلال شود. اگر لازم است یک مسیر حیاتی را از ابتدا تا انتها بیازمایید، آن را بهصورت Synthetic Monitoring جدا و با داده آزمایشی، محدودیت نرخ و برنامه پاکسازی طراحی کنید.
آموزش قدمبهقدم تست API با curl
برای شروع لازم نیست بلافاصله ابزار پیچیده نصب کنید. یک درخواست دستی میتواند قرارداد اولیه سلامت را روشن کند. مثلاً اگر API تستی در اختیار دارید، در ترمینال چنین دستوری بزنید:
curl -i --connect-timeout 3 --max-time 5 \
  https://api.example.com/health
گزینه -i هدرهای پاسخ را نشان میدهد. --connect-timeout زمان انتظار برای برقراری اتصال را محدود میکند و --max-time سقفی برای کل اجرای درخواست میگذارد. نشانی بالا نمونه است و باید آن را با endpoint واقعی خودتان جایگزین کنید. اگر خروجی 200 گرفتید، بدنه پاسخ را نیز بررسی کنید؛ ممکن است تنها یک پیام ثابت باشد و آمادگی عملیاتی را نشان ندهد.
برای مشاهده مدت پاسخ میتوانید از -w کمک بگیرید:
curl -sS -o /dev/null --max-time 5 \
  -w 'HTTP: %{http_code} | total: %{time_total}s\n' \
  https://api.example.com/health
این اندازهگیری برای یک درخواست کاربرد دارد، نه برای قضاوت قطعی درباره عملکرد در تمام ساعات روز. زمان DNS، TLS، مسیر شبکه و پردازش برنامه همگی میتوانند روی زمان نهایی اثر بگذارند. یک نمونه موفق در لپتاپ شما جای تاریخچه پایش از موقعیت شبکه ثابت و در بازههای منظم را نمیگیرد.
کدام کدهای HTTP نشانه اختلالاند؟
کد وضعیت بدون آگاهی از قرارداد endpoint گاهی گمراهکننده است. برای مانیتور صفحهای عمومی، 200 اغلب نشانه خوبی است. اما برای API اختصاصی، شاید پاسخ موفق 204 باشد؛ درخواست اشتباه هم بهدرستی 400 میگیرد. از سوی دیگر، یک مانیتور بدون اعتبارنامه ممکن است دائماً 401 ببیند، حتی وقتی API سالم است.
| نشانه | تفسیر محتمل | اقدام اولیه |
|---|---|---|
2xx | درخواست در سطح HTTP موفق بوده است | در صورت امکان، اعتبار محتوای پاسخ را هم بسنجید |
401 / 403 | نیاز به احراز هویت یا محدودیت دسترسی | توکن، سطح دسترسی و انتظار مانیتور را کنترل کنید |
404 | مسیر پیدا نشده است | URL، نسخه API و مسیر Deploy را بررسی کنید |
429 | محدودیت نرخ درخواست | فاصله پایش و Rate Limit را تطبیق دهید |
500 / 502 / 503 / 504 | خطای سرور، درگاه یا سرویس وابسته | لاگ برنامه، پروکسی و وابستگیها را همزمان ببینید |
| Timeout | پاسخ در زمان مقرر نرسیده است | DNS، شبکه، TLS، سرور و مدت پردازش را تفکیک کنید |
یک نکته مهم: خطای 502 ممکن است از Reverse Proxy بیاید، نه از خود برنامه. کد 504 هم همیشه به معنی خاموشبودن سرور نیست؛ ممکن است برنامه زیر فشار یا منتظر دیتابیس کند مانده باشد. مانیتور خوب نقطه شروع بررسی را نشان میدهد، نه اینکه بدون شواهد علت قطعی را اعلام کند.
تفاوت Uptime، Response Time و Error Rate چیست؟
وقتی داشبورد مانیتورینگ را باز میکنید، چند عدد کنار هم قرار میگیرند که هرکدام داستان متفاوتی دارند. Uptime سهم بررسیهایی است که طبق تعریف شما موفق بودهاند. مثلاً اگر از ۱۰۰ بررسی، ۹۹ مورد موفق باشد، نرخ موفقیت همان مجموعه ۹۹ درصد است؛ این عدد لزوماً معادل درصد درخواستهای واقعی کاربران یا یک تعهد قراردادی SLA نیست. برای محاسبه درست باید تعریف موفقیت، فاصله زمانی و نحوه برخورد با دادههای گمشده مشخص باشد.
Response Time مدت زمانی است که تا دریافت پاسخ میگذرد. میانگین زمان پاسخ میتواند کندی کاربران بدشانس را پنهان کند. در سامانههایی که متریک درخواستهای واقعی را جمع میکنند، صدکهایی مثل p95 و p99 کمک میکنند رفتار کندترین بخش درخواستها را ببینیم. اما وقتی فقط هر چند دقیقه یک Health Check انجام میدهیم، نباید صدک چند نمونه محدود را به عملکرد همه کاربران تعمیم دهیم.
Error Rate هم نسبت خطاها به کل درخواستها یا بررسیهاست؛ این دو تعریف باید از هم جدا بمانند. یک سرویس ممکن است در تمام تستهای ساده Health Check موفق باشد، اما در مسیر پرداخت خطا دهد. برای همین است که ترکیب پایش دسترسپذیری با لاگ، متریک برنامه و در صورت نیاز سناریوهای ساختگی ارزش بیشتری از یک عدد تنها دارد.
چطور اختلال واقعی را از قطعی لحظهای تشخیص دهیم؟
هیچ تیمی دوست ندارد بهخاطر یک Packet Loss کوتاه، نیمهشب با پنج پیام هشدار از خواب بپرد. از طرف دیگر، اگر شرط هشدار بیش از حد سخت باشد، یک API حیاتی چندین دقیقه از دسترس خارج میماند و کسی خبردار نمیشود. راهحل، تعریف آستانه متناسب با اهمیت سرویس و تجربه کاربران است.
فاصله بررسی را چگونه انتخاب کنیم؟
برای API پرداخت یا ورود کاربران، فاصله کوتاهتر میتواند ارزشمند باشد؛ برای ابزار داخلی کممصرف شاید چند دقیقه کافی باشد. با بررسی هر یک دقیقه، اختلالی که درست بعد از یک بررسی شروع میشود ممکن است تا بررسی بعدی دیده نشود. کوتاهترکردن فاصله هم رایگان نیست: تعداد درخواستها بیشتر میشود و اگر مسیر Health Check سنگین باشد، بار اضافی به برنامه تحمیل میکند.
چند شکست متوالی برای ارسال هشدار کافی است؟
یک الگوی رایج این است که پس از دو یا سه شکست پشتسرهم هشدار بدهیم و هنگام بازگشت سرویس پیام بازیابی بفرستیم؛ اما این فقط یک نقطه شروع برای طراحی است، نه تنظیم جهانی. اگر هر بررسی یک دقیقه طول بکشد، شرط سه شکست میتواند چند دقیقه تأخیر در اعلام اختلال ایجاد کند. برای سرویس حساس، ممکن است هشدار سریعتر لازم باشد و برای سرویس پرنویز، تأیید بیشتر مناسبتر باشد.
هشدارهای تکراری را نیز مهار کنید. وقتی دیتابیس مشترک قطع شده، ده API وابسته ممکن است همزمان خطا دهند؛ بهتر است تیم یک حادثه روشن با دامنه اثر ببیند، نه دهها اعلان تقریباً یکسان. این مسئله در بحث خستگی هشدار در مانیتورینگ سرور اهمیت زیادی دارد.
Timeout را بر چه اساسی تنظیم کنیم؟
اگر پاسخ عادی یک API حدود ۳۰۰ میلیثانیه است، Timeout سی ثانیهای احتمالاً برای تشخیص سریع کندی مناسب نیست. در مقابل، برای عملیاتی که ذاتاً چند ثانیه زمان میبرد، Timeout یکثانیهای هشدارهای کاذب میسازد. ابتدا رفتار معمول، حساسیت تجربه کاربر و هدف سرویس را بشناسید. سپس آستانهای بگذارید که واقعاً به تصمیم عملیاتی کمک کند.
سناریوی واقعینما: صفحه باز میشود اما پرداخت شکست میخورد
یک فروشگاه فرضی را در نظر بگیرید. کاربران محصولات را میبینند، سبد خرید را پر میکنند و در مرحله نهایی با خطا روبهرو میشوند. مانیتور صفحه اصلی همچنان سبز است، چون مشکل در مسیر سفارش یا اتصال درگاه اتفاق افتاده. اگر فقط یک مانیتور برای دامنه داشته باشید، هیچ نشانه دقیقی از این شکست به دست نمیآورید.
برای چنین کسبوکاری دستکم باید مسیرهای حیاتی را فهرست کرد: نمایش اطلاعات محصول، ساخت سفارش، احراز هویت و ارتباط با درگاه. پایش بیرونی ساده میتواند در دسترس بودن endpointهای مجاز را نشان دهد. آزمون کامل پرداخت، بهدلیل حساسیت مالی، نباید با تراکنش واقعی و بیبرنامه انجام شود؛ برای آن محیط Sandbox، حساب آزمایشی، کنترل تکرار و پاکسازی داده نیاز است. هدف این است که نظارت به یک منبع خطر تازه تبدیل نشود.
وقتی هشدار آمد، زمان دقیق شروع خطا را کنار گزارش Deploy، تغییرات تنظیمات، وضعیت دیتابیس و خطاهای Reverse Proxy بگذارید. چنین تطبیقی کمک میکند بفهمید مشکل در شبکه است، در خود API رخ داده یا از سرویس ثالث میآید. برای بررسی گلوگاه دادهها، مقاله مانیتورینگ دیتابیس و تشخیص Query کند مکمل مناسبی است.
برای پایش API چه چیزهایی را از روز اول مشخص کنیم؟
یکی از دلایل بیاستفادهماندن ابزار مانیتورینگ این است که تیم بدون انتخاب هدف، دهها مانیتور میسازد و بعد نمیداند با پیامهایشان چه کند. بهتر است با سرویسهایی شروع کنید که خرابیشان مستقیماً ثبت سفارش، ورود کاربر یا کار روزانه تیم را مختل میکند. نام هر مانیتور باید بهروشنی بگوید چه چیزی بررسی میشود؛ «API-1» در زمان بحران کمکی نمیکند، اما «ورود کاربران ـ پاسخ HTTP» قابلفهم است.
- فهرست وابستگیها را بنویسید. مشخص کنید کدام endpoint به دیتابیس، کش، صف پیام یا سرویس ثالث وابسته است. اگر چند مسیر به یک زیرساخت مشترک متصلاند، این رابطه هنگام عیبیابی مهم میشود.
- رفتار سالم را تعریف کنید. برای هر مسیر کد پاسخ مورد انتظار، بازه زمانی قابلقبول و در صورت پشتیبانی ابزار، شرط محتوایی را ثبت کنید. مانیتوری که همه پاسخهای 4xx را شکست بداند ممکن است برای API احراز هویت مناسب نباشد.
- روش احراز هویت را ایمن انتخاب کنید. برای مسیر محافظتشده از هویت سرویس با حداقل دسترسی و توکن قابل چرخش استفاده کنید. توکن را در URL، عنوان مانیتور یا متن قابلاشتراک هشدار قرار ندهید.
- گیرنده هشدار را تعیین کنید. کسی باید بداند هنگام اختلال چه کاری انجام دهد. اگر اعلان به صندوق ایمیلی میرود که هیچکس آن را نگاه نمیکند، عملاً هشدار ندارید.
- پس از راهاندازی آزمایش کنید. در محیط کنترلشده یک شکست بیخطر شبیهسازی کنید و ببینید وضعیت مانیتور، زمان هشدار و پیام بازیابی مطابق انتظار است یا خیر.
امنیت Health Check؛ مسیر کوچک، ریسکهای بزرگ
Health Check عمومی نباید پنجرهای به داخل زیرساخت باز کند. نمایش نسخه دقیق کتابخانهها، IP داخلی دیتابیس، کلید دسترسی، مسیر فایلهای سرور یا متن کامل Exception برای مهاجم اطلاعات ارزشمندی فراهم میکند. اطلاعات حساس را پشت احراز هویت و شبکه مدیریت نگه دارید و پاسخ عمومی را محدود به آنچه واقعاً برای سنجش سلامت لازم است کنید.
همچنین مراقب SSRF و ابزارهایی باشید که URL دلخواه کاربر را از شبکه داخلی فراخوانی میکنند؛ یک سامانه مانیتورینگ باید برای نشانیهای خصوصی، متادیتای ابری، تغییر مسیرهای ناامن و دسترسی غیرمجاز سیاست مشخص داشته باشد. اگر از سرویس بیرونی برای پایش استفاده میکنید، نشانی مقصد باید مجاز باشد و دادههای محرمانه در پاسخ قابل مشاهده نباشند.
اگر سرویس شما پشت WAF یا محدودیت IP قرار دارد، پیش از نتیجهگیری درباره قطعی، مطمئن شوید مسیر پایش عمداً مسدود نشده است. از آن طرف، بازکردن یک API حساس به روی تمام اینترنت فقط برای سبزشدن مانیتور تصمیم درستی نیست. راهحل باید با مدل امنیتی برنامه سازگار باشد.
مانیتورینگ API با لاگگیری و APM چه تفاوتی دارد؟
این سه ابزار سؤالهای متفاوتی جواب میدهند. مانیتور بیرونی بیشتر میپرسد «آیا سرویس از این نقطه قابل دسترس و پاسخگوست؟» لاگها جزئیات رویدادها و خطاهای ثبتشده را نشان میدهند. APM و Distributed Tracing، در صورت پیادهسازی، کمک میکنند مسیر اجرای یک درخواست را میان اجزای برنامه دنبال کنید و گلوگاه دقیقتری پیدا کنید.
هیچکدام بهتنهایی تصویر کاملی نمیسازند. مثلاً مانیتور بیرونی ممکن است Timeout ببیند، لاگ Nginx خطای Gateway Timeout ثبت کرده باشد و Trace نشان دهد سرویس برای دریافت پاسخ دیتابیس منتظر مانده است. استفاده از زمان مشترک، شناسه درخواست و گزارش Deploy در کنار این ابزارها، تشخیص را قابلاتکاتر میکند.
مانیتورینگ آوازتک چه کمکی به شروع کار میکند؟
اگر تا امروز فقط گاهی با مرورگر یا دستور curl سرویسها را بررسی کردهاید، قدم بعدی میتواند ثبت بررسیهای منظم و دیدن تاریخچه آنها در یک داشبورد باشد. Avaztek Monitoring در صفحه رسمی خود پایش HTTP، TCP و ICMP را در کنار وضعیت منابع سرور، دیتابیس، SSL و هشدارها معرفی میکند. این ترکیب برای تیمی که میخواهد دسترسپذیری یک API را کنار وضعیت زیرساخت میزبانش ببیند، نقطه شروع خوبی است.
البته شفاف بگوییم: پایش HTTP بهخودیخود به معنی اجرای سناریوی چندمرحلهای خرید، اعتبارسنجی کامل JSON یا تست خودکار منطق تجاری API نیست. اگر این نیازها برایتان حیاتی است، پیش از انتخاب نهایی جزئیات امکانات هر پلن و شیوه تنظیم مانیتور را بررسی کنید. میتوانید پایش بیرونی را با تستهای داخلی برنامه و لاگها ترکیب کنید تا برداشت دقیقتری داشته باشید.
مزیت شروع ساده این است که لازم نیست از روز اول همه زیرساخت را وارد ابزار کنید. یک endpoint مهم و کمخطر انتخاب کنید، وضعیت پاسخ آن را زیر نظر بگیرید، هشدارهایش را ارزیابی کنید و بعد دامنه پایش را گسترش دهید. چنین شروعی از ساخت دهها مانیتور بیصاحب، عملیتر است.
پلن رایگان مانیتورینگ آوازتک برای چه کسی مناسب است؟
طبق صفحه رسمی پلنهای مانیتورینگ آوازتک، پلن رایگان برای آغاز و ارزیابی سرویس ارائه میشود و در وضعیت فعلی تا ۳ سرور فعال و ۷ روز نگهداری داده و لاگ را ذکر میکند. هشدار پیامکی در این پلن غیرفعال است، بنابراین اگر واکنش شما به SMS وابسته است، باید شرایط پلنهای دیگر را بررسی کنید. محدودیتها و امکانات ممکن است تغییر کنند؛ مرجع نهایی همان صفحه پلنهاست.
برای توسعهدهنده مستقل، تیم تازهکار یا کسبوکاری با زیرساخت کوچک، همین نقطه شروع رایگان میتواند ارزشمند باشد. لازم نیست تا روزی که یک API مهم از کار میافتد صبر کنید. پلنها را همین حالا ببینید و اگر در حال ارزیابی هستید، دستکم از پلن رایگان آغاز کنید. پس از ساخت حساب، یک سرویس مجاز را اضافه کنید و نتیجه اولین بررسیها را ببینید؛ سپس برای نیازهای حساستر تصمیم بگیرید.
اگر علاوه بر APIها، چند سرور، دیتابیس و سرویس شبکه دارید، مطالعه راهنمای مقایسه ابزارهای مانیتورینگ سرور هم کمک میکند بدانید چه زمانی ابزار مدیریتشده، مانیتورینگ خودمیزبان یا ترکیبی از آنها منطقیتر است.
اشتباههای رایج در مانیتورینگ API
اولین اشتباه، یکیگرفتن «سرور روشن است» با «سرویس سالم است» است. ممکن است تمام ماشینهای شما روشن باشند، اما تنها یک تنظیم اشتباه در ارتباط بین دو سرویس، فرایند سفارش را مختل کرده باشد. اشتباه دوم، اعتماد مطلق به یک بررسی ساده است. اگر Health Check فقط رشته OK برگرداند، قطع اتصال دیتابیس را نمیفهمد؛ این موضوع لزوماً بد نیست، به شرط آنکه بدانید این بررسی صرفاً Liveness است.
اشتباه سوم، هشدار بدون مالک مشخص است. وقتی هیچکس مسئول دریافت، بررسی و اعلام پایان حادثه نباشد، حتی دقیقترین سیستم پایش هم از کاربران محافظت نمیکند. اشتباه چهارم نیز اعتماد به عدد میانگین است؛ اگر برخی درخواستها بسیار کند باشند، میانگین خوب میتواند آنها را پنهان کند. در نهایت فراموش نکنید مانیتورینگ باید خودش هم تحت کنترل باشد: اگر ابزار پایش برای مدتی داده جمع نکند، نبودن هشدار به معنی سالمبودن سرویس نیست.
چکلیست عملی قبل از فعالکردن مانیتور
- نشانی endpoint و روش HTTP را با قرارداد واقعی API تطبیق دادهام.
- میدانم پاسخ سالم چه وضعیت و محتوایی باید داشته باشد.
- Timeout و فاصله بررسی را متناسب با اهمیت سرویس انتخاب کردهام.
- برای خطاهای تکراری و پیام بازیابی، روند مشخصی دارم.
- توکن، کلید، اطلاعات کاربر و جزئیات داخلی در پاسخ عمومی لو نمیروند.
- تیم میداند پس از دریافت هشدار کدام لاگ و داشبورد را بررسی کند.
- حداقل یک بار در محیط امن، فرایند تشخیص و اطلاعرسانی را آزمایش کردهام.
پرسشهای متداول درباره مانیتورینگ API و Health Check
آیا مانیتورینگ API با مانیتورینگ سایت فرق دارد؟
بله. مانیتورینگ سایت معمولاً دسترسپذیری صفحات وب را بررسی میکند، اما مانیتورینگ API میتواند روی endpointهای مشخص و قرارداد پاسخ آنها متمرکز باشد. اگر صفحه اصلی باز شود ولی API ثبت سفارش خطا بدهد، فقط بررسی صفحه اصلی کافی نیست. البته بخشی از فناوریهای این دو نوع پایش مشترکاند.
آیا پاسخ 200 برای سالمبودن API کافی است؟
خیر. کد 200 فقط نشان میدهد درخواست در سطح HTTP موفق گزارش شده است. صحت داده، تازگی پاسخ، عملکرد وابستگیها و سناریوی واقعی کاربر ممکن است نیازمند آزمونهای دیگری باشد. بهتر است تعریف موفقیت را برای هر API و متناسب با کاربرد آن بنویسید.
Health Check را هر چند دقیقه یک بار اجرا کنیم؟
بازه ثابت و یکسانی برای همه سرویسها وجود ندارد. شدت اثر اختلال، بار خود بررسی، نرخ تغییر وضعیت و سرعت مورد نیاز برای واکنش مهماند. برای مسیرهای حساس ممکن است بررسی نزدیکتر مناسب باشد و برای سرویسهای غیرحیاتی بازه طولانیتر. قبل از انتخاب، تأخیر احتمالی در تشخیص را حساب کنید.
چرا API گاهی فقط از یک اینترنت خطا میدهد؟
مشکلات DNS، مسیر شبکه، CDN، فایروال یا اپراتور اینترنت میتوانند منطقهای باشند. نتیجه یک مانیتور تنها از یک نقطه، سلامت همه مسیرهای دسترسی را تضمین نمیکند. اگر کاربران در مکانهای مختلف دارید، به دادههای شبکه و در صورت امکان پایش چندنقطهای نیز نیاز خواهید داشت.
آیا برای شروع مانیتورینگ API باید هزینه پرداخت کنم؟
الزاماً نه. در صفحه پلنهای مانیتورینگ آوازتک یک پلن رایگان معرفی شده است که برای ارزیابی اولیه مناسب است. محدودیت سرورها، مدت نگهداری داده و روش اعلانها را در همان صفحه مطالعه کنید تا بدانید با نیاز تیم شما سازگار است یا نه.
بعد از دریافت هشدار اختلال، اولین اقدام چیست؟
ابتدا مشکل را از مسیر مجاز دیگری تأیید کنید و ساعت رخداد را ثبت کنید. سپس لاگ برنامه، پروکسی، دیتابیس، وضعیت شبکه و تغییرات اخیر را با همان بازه زمانی تطبیق دهید. بدون شواهد، سرویسهای تولید را پشتسرهم Restart نکنید؛ گاهی این کار اثر حادثه را بیشتر و سرنخ عیبیابی را کمتر میکند.
جمعبندی؛ پیش از اولین شکایت، از وضعیت API خبر داشته باشید
مانیتورینگ API قرار نیست بهجای معماری درست، تست نرمافزار یا رسیدگی تیم فنی بنشیند. نقش آن روشنتر است: اختلال را زودتر قابل مشاهده کند، زمان شروع مشکل را ثبت کند و نشانهای برای اقدام بدهد. Health Check خوب باید با کاربرد واقعی سرویس همخوان باشد؛ هشدار خوب هم باید دقیقاً به کسی برسد که میتواند مسئله را بررسی کند.
اگر هنوز حتی یک مانیتور برای API یا سرویس حیاتی خود ندارید، شروع را به بعد موکول نکنید. به مانیتورینگ آوازتک سر بزنید، صفحه پلنها را مقایسه کنید و با پلن رایگان، یک پایش ساده و قابلاندازهگیری راه بیندازید. اولین قدم کوچک است؛ ارزشش این است که دفعه بعد درباره وضعیت سرویس، بهجای حدسزدن دادهای برای بررسی داشته باشید.
نظرات و گفتوگو
نظرها پس از تایید مدیر منتشر میشوند. پاسخهای رسمی مدیر با نشان مشخص نمایش داده میشوند.