
هشدار هوشمند مانیتورینگ سرور؛ پایان پیامهای کاذب و خستگی هشدار
چطور هشدارهای مانیتورینگ سرور را واقعاً قابلاعتماد کنیم؟ آموزش عملی Alert Fatigue، Cooldown، Recovery، هشدار چندشرطی، گروهبندی رخدادها و کاهش پیامهای تکراری با معرفی مانیتورینگ آواتک.
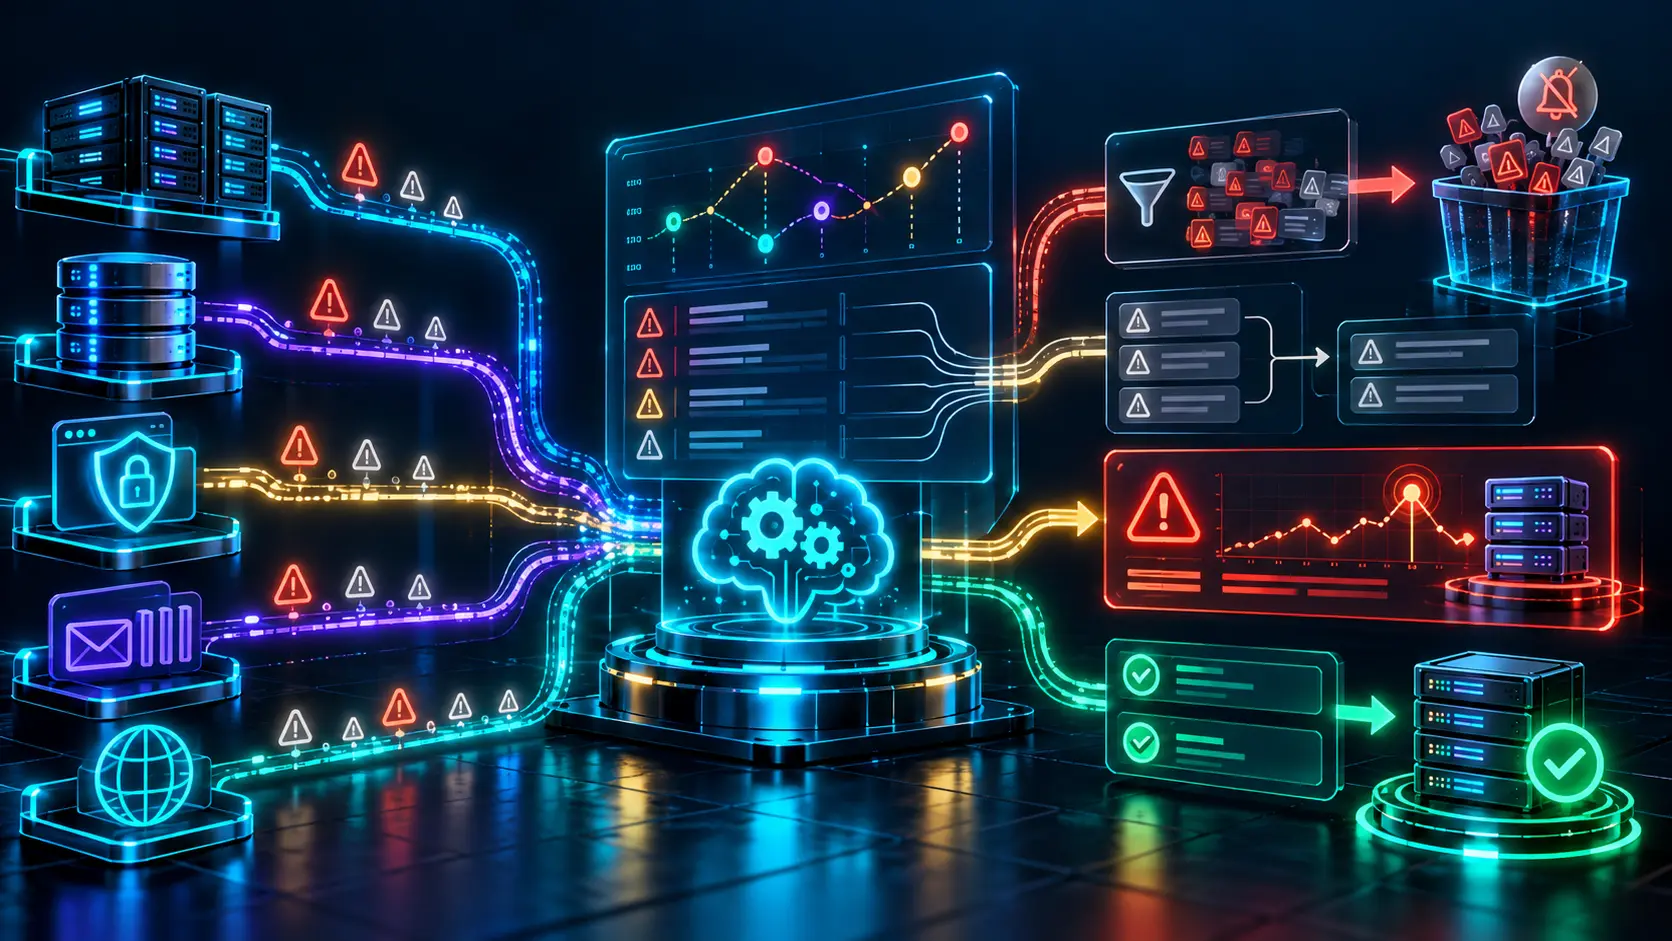
ساعت ۳ صبح گوشی مدیر سرور ۴۰ بار زنگ میخورد؛ CPU چند ثانیه بالا رفته، سرویس دوباره عادی شده و چند هشدار تقریباً یکسان برای یک مشکل ارسال شده است. فردا که قطعی واقعی دیتابیس رخ میدهد، کسی به هشدار تازه توجه نمیکند. این همان خستگی هشدار (Alert Fatigue) است: مسئلهای که باعث میشود حتی دقیقترین ابزار مانیتورینگ سرور نتواند به تیم عملیات کمک کند.
این مقاله درباره نصب ابزار و توضیح ابتدایی CPU یا RAM نیست؛ تمرکز ما روی ساختن سیستم هشدار هوشمند و کمخطا است. با مثالهای واقعی از Cron، PHP-FPM، صف پردازش، SSL و پایگاهداده یاد میگیریم چرا یک عدد لحظهای نباید باعث بحران شود، چگونه ارتباط میان چند رخداد را پیدا کنیم و چه نوع هشداری واقعاً ارزش بیدارکردن مسئول شیفت را دارد.
هشدار هوشمند مانیتورینگ سرور یعنی چه؟
هشدار خام میگوید «CPU = ۹۰٪». هشدار هوشمند میگوید «زمان پاسخ خرید در ۵ دقیقه گذشته از حد هدف خارج شده، صف PHP-FPM رو به افزایش است و مصرف CPU همزمان نزدیک ظرفیت قرار دارد؛ مسئول بررسی: تیم زیرساخت». تفاوت در قابلیت اقدام است. یک هشدار باید درباره مشکل مهم، در زمان درست، با اطلاعات کافی و به فرد مناسب ارسال شود.
سه سؤال ساده کیفیت هر هشدار را نشان میدهد: آیا پیام به مشکلی قابلاقدام اشاره میکند؟ آیا گیرنده میداند اولین بررسی چیست؟ آیا میتوان بهصورت قابلاعتماد فهمید مشکل چه زمانی برطرف شد؟ اگر جواب یکی از اینها منفی است، احتمالاً باید قانون هشدار بازطراحی شود.
Metric، Event و Incident را یکی نگیریم
Metric مقدار اندازهگیریشده مانند فضای دیسک است. Event یک رخداد مشخص مثل Restart سرویس یا شروع Deploy است. Incident وضعیتی است که اثر واقعی بر سرویس دارد و نیازمند مدیریت هماهنگ است. هر Event نباید Incident باشد و هر جهش Metric نباید اعلان فوری ایجاد کند. اتصال این سه لایه، اساس حذف هشدارهای کمارزش است.
از آستانه ثابت تا هشدار چندشرطی
نوشتن «اگر CPU از ۸۵٪ عبور کرد، هشدار بده» ساده است؛ اما ممکن است اجرای یک گزارش روزانه، فشردهسازی فایل یا کار زمانبندیشده باعث عبور کوتاهمدت از همان مرز شود. این اتفاق لزوماً بد نیست، بهخصوص اگر سرعت پاسخ کاربران سالم بماند. در عوض، یک API ممکن است با CPU معمولی، بهدلیل انتظار برای دیتابیس از کار بیفتد.
| قانون خام | نسخه دقیقتر | فایده |
|---|---|---|
| CPU بیش از ۸۵٪ | CPU بالا برای ۵ دقیقه + رشد تأخیر برنامه | کاهش هشدار کارهای کوتاهمدت |
| فضای دیسک بیشتر از ۸۰٪ | فضای آزاد کم + پیشبینی رسیدن به حد بحرانی | فرصت اقدام قبل از توقف سرویس |
| یک پاسخ HTTP ناموفق | چند خطای متوالی + تأیید از مسیر یا Endpoint دیگر | کاهش حساسیت به اختلال گذرا |
| یک Worker متوقف | توقف Worker + افزایش سن قدیمیترین Job | تشخیص اختلال واقعی پردازش صف |
| SSL کمتر از ۳۰ روز | یادآوری مرحلهای + تأیید تمدید خودکار | جلوگیری از اعلانهای تکراری روزانه |
اعداد این جدول مثال آموزشی هستند و باید با رفتار واقعی همان سرور تنظیم شوند. اگر سرویس مهمی نباید حتی ۳۰ ثانیه قطع شود، ممکن است قانون HTTP به پنجره کوتاهتری نیاز داشته باشد؛ ولی مانیتور Disk معمولاً به پنجره زمانی بلندتری نیاز دارد.
Pending، Firing و Resolved؛ سه وضعیت ضروری هشدار
وقتی مقدار از حد مجاز عبور کرد، هشدار بهتر است ابتدا در وضعیت Pending قرار بگیرد. اگر مشکل بهاندازه تعیینشده ادامه یافت، Firing و قابل اطلاعرسانی شود. پس از بازگشت پایدار شرایط عادی، Resolved اعلام شود. جداکردن این وضعیتها مانع ایجاد پیام هشدار برای هر نوسان یکثانیهای میشود.
Hysteresis یا آستانه بازگشت متفاوت
فرض کنیم بالارفتن مصرف حافظه از ۸۵٪ باعث هشدار شود. اگر برای رفع هشدار هم همان ۸۵٪ معیار باشد، مقدارهای ۸۴٫۹ و ۸۵٫۱ میتوانند وضعیت را مرتب تغییر دهند؛ این پدیده Flapping است. راهکار بهتر تعریف بازه برگشت است؛ مثلاً هشدار در ۸۵٪ فعال شود و پس از پایینآمدن به ۷۸٪ و ماندن در آن وضعیت، بسته شود. این اعداد نمونهاند و باید با شرایط سرور تطبیق یابند.
Cooldown، Deduplication و Grouping چگونه نویز را حذف میکنند؟
Cooldown جلوی ارسال مکرر یک پیام برای مشکل حلنشده را میگیرد. Deduplication چند رخداد معادل را با شناسه ثابت به یک مسئله تبدیل میکند. Grouping هشدارهای مرتبط، مثل افزایش خطای API در پنج برنامه وابسته به یک دیتابیس، را در یک رویداد عملیاتی جمع میکند. این مفاهیم شبیهاند اما جای هم را نمیگیرند.
کلید گروهبندی میتواند ترکیبی از شناسه سرویس، نوع مشکل، محیط و ناحیه باشد. برای مثال production + payment-db + connection-pool بهتر از گروهبندی صرفاً بر اساس «همه خطاهای دیتابیس» است. اگر کلید خیلی گسترده باشد، حوادث مستقل زیر هم مخفی میشوند؛ اگر خیلی محدود باشد، دوباره با صدها هشدار روبهرو خواهیم شد.
چه زمانی اعلان تکراری واقعاً لازم است؟
اگر مشکل بحرانی هنوز حل نشده و هیچ مسئولی رسیدگی را تأیید نکرده است، تکرار یا تشدید هشدار معقول است. اما اگر Incident در حال بررسی است، هر نمونه جدید CPU نباید بهعنوان حادثه تازه ارسال شود. سیاست تکرار باید به Severity، Acknowledgement و Escalation وابسته باشد، نه صرف زمانسنجی ثابت برای همه سرویسها.
اولویتبندی هشدارها با توجه به تجربه واقعی کاربران
مهمترین تفاوت مانیتورینگ حرفهای با یک داشبورد پرنمودار این است که اولویت هشدار بر اساس اثر بر کاربر و کسبوکار مشخص شود. خطا در محیط آزمایش با خطا در مسیر پرداخت یکسان نیست؛ همینطور هشدار افزایش مصرف CPU یک سرور پردازش ویدیویی با ازکارافتادن سیستم ورود کاربران تفاوت دارد.
| سطح | شرایط نمونه | شیوه رسیدگی |
|---|---|---|
| بحرانی / P1 | قطع مسیر اصلی مشتریان یا خطر ازدسترفتن داده | اطلاع فوری به مسئول آمادهباش و شروع Incident |
| بالا / P2 | افت قابلتوجه عملکرد، افزایش خطا یا تهدید نزدیک ظرفیت | ارجاع سریع به تیم مرتبط و پیگیری زمانبندیشده |
| متوسط / P3 | رشد آرام مصرف منابع یا کاهش حاشیه ظرفیت | ثبت کار اصلاحی و بررسی در ساعات کاری |
| اطلاعاتی | Deploy انجام شد، Backup کامل شد، سرویس بازیابی شد | ثبت در تاریخچه و اعلان غیرمزاحم |
برای هر Severity باید مسئول، کانال اطلاعرسانی، زمان واکنش موردانتظار و روش Escalation تعیین شود. این جدول جایگزین برنامه پاسخگویی سازمان نیست؛ فقط چارچوبی برای طراحی آن است.
نمونه عملی: چگونه ۴۰ هشدار CPU به یک Incident مفید تبدیل میشود؟
فرض کنیم سروری هشت هسته CPU دارد و هر شب یک Job فشردهسازی اجرا میشود. در زمان اجرا، مصرف سه دقیقه به ۹۳٪ میرسد، اما زمان پاسخ API ثابت است و صف کاربر عقب نمیافتد. قانون تکشرطی در هر نمونه هشدار میدهد و تیم عملیات هشدار را خاموش میکند. چند روز بعد یک حلقه پردازشی معیوب همزمان با افت تجربه کاربران اتفاق میافتد، ولی کسی آن را نمیبیند.
- رفتار Job شبانه را در تاریخچه مشخص میکنیم و پنجره زمانی آن را ثبت میکنیم؛ بدون اینکه هشدارهای مهم را کورکورانه حذف کنیم.
- قانون «CPU بالا برای بیش از ۵ دقیقه» را از اعلان یکنمونهای جایگزین میکنیم.
- شرط دوم «افزایش p95 زمان پاسخ یا سن صف» را برای هشدار با Severity بالا اضافه میکنیم.
- اگر CPU بالا رفت ولی کاربران تحت تأثیر نبودند، رویداد برای تحلیل ظرفیت ثبت میشود.
- اگر CPU و تأخیر همزمان بالا رفتند، یک Incident واحد با اطلاعات پردازشهای سنگین و زمان شروع ایجاد میشود.
- بعد از حل مشکل، Recovery فقط وقتی ارسال میشود که مقدارها برای مدت کافی پایدار مانده باشند.
این طراحی از «حذف هشدار» دقیقتر است؛ دادهها باقی میمانند و تیم بهجای نویز، پیام باارزش دریافت میکند. درباره ابزارهای پایه و نحوه خواندن شاخصها نیز راهنمای جامع مانیتورینگ سرور آواتک را ببینید.
هشدارهای وابستگی؛ چرا یک خرابی میتواند دهها پیام تولید کند؟
گاهی برنامهها سالماند اما وابستگی مشترک آنها مثل Redis، دیتابیس یا مسیر شبکه مشکل دارد. در چنین حالتی HTTP چند سرویس خطا میدهد، صفها عقب میافتند و مصرف منابع به شکل غیرعادی تغییر میکند. اگر هرکدام مستقل هشدار دهند، دریافتکننده نمیداند مشکل را از کجا شروع کند.
Dependency Mapping یا نقشه وابستگیها مشخص میکند کدام سرویس به چه چیزی نیاز دارد. فرض کنید «وبسایت ← API ← دیتابیس» و «پردازشگر صف ← Redis» زنجیرههای اصلی هستند. وقتی دیتابیس از دسترس خارج شد، سیستم میتواند آن را رخداد محتمل ریشهای معرفی کند و هشدارهای ناشی از شکست API را زیر همان حادثه گروهبندی کند؛ البته باید امکان رخداد همزمان و علت متفاوت هم بررسی شود.
در زمان Deploy چگونه هشدار کاذب ندهیم؟
Deploy میتواند بهطور کنترلشده پردازشها را Restart کند یا چند ثانیه زمان پاسخ را افزایش دهد. Maintenance Window برای اطلاعرسانی برنامهریزیشده مفید است، ولی خاموشکردن همه هشدارها در زمان انتشار کد خطرناک است. بهتر است نوع Deploy، سرور تحت تأثیر، مدت پیشبینیشده و مسیرهای حیاتی مشخص باشند؛ هشدار خطای کوتاه و موردانتظار بهطور محدود Suppress شود، اما خرابی طولانی، خطای پرداخت یا مشکل واقعی دیتابیس همچنان قابل تشخیص بماند.
در سرویسهای پرترافیک، علاوه بر بررسی سلامت HTTP، Readiness واقعی را از شاخصهای جانبی مثل زمانبند یا بررسی SSL جدا کنید. اگر تنها یک بررسی جانبی موقتاً شکست خورد اما برنامه هنوز سفارشها را پردازش میکند، بهتر است دیپلوی فقط به دلیل همان سیگنال غیرحیاتی ناموفق اعلام نشود. در مقابل، شکست اتصال دیتابیس ضروری میتواند دلیل معتبر ردکردن انتشار باشد.
الگوی پیام هشدار خوب؛ چه اطلاعاتی داخل اعلان باشد؟
اعلان «Server is down» بدون نام سرویس، زمان شروع یا مسیر بررسی کمک چندانی نمیکند. یک پیام عملیاتی خوب بهتر است فیلدهای زیر را داشته باشد:
- چه چیزی؟ نام سرویس و شناسه سرور، مثلاً
payment-api / production. - چه زمانی؟ زمان شروع و طول مدت مشکل، همراه با منطقه زمانی واضح.
- اثر بر کاربر: مثلاً افزایش خطای 5xx یا کندی مسیر ورود.
- شواهد: مقدار فعلی، آستانه، روند پنج دقیقه اخیر و همبستگی با رخداد Deploy.
- چه اقدامی؟ لینک داشبورد، لاگها یا دستورالعمل کوتاه پاسخگویی.
- مسئول و وضعیت: تیم دریافتکننده، شناسه Incident، Acknowledgement و زمان Recovery.
بهتر است لینک پیام به نمای فیلترشده همان حادثه باز شود، نه صفحه اصلی داشبورد. همچنین دسترسی به اطلاعات حساس را از طریق مجوز کاربر کنترل کنید؛ نمایش توکن، رمز عبور، اطلاعات شخصی یا متن کامل لاگ حساس داخل اعلان عمومی مجاز نیست.
چگونه کیفیت سیستم هشدار را اندازه بگیریم؟
هدف «صفرشدن تعداد هشدارها» نیست. کیفیت هشدار را با این معیارها بهتر میتوان سنجید:
| معیار | چه چیزی نشان میدهد؟ | نشانه مشکل |
|---|---|---|
| هشدارهای تکراری برای هر Incident | کارایی Deduplication و Grouping | چندین پیام برای یک ریشه خرابی |
| نرخ هشدار بیاقدام | میزان نویز قوانین | پیامهای زیاد بدون اقدام مشخص |
| زمان تشخیص / MTTD | سرعت شناسایی حادثه | مدت زیاد بین شروع مشکل و اولین پیام معتبر |
| زمان تأیید / MTTA | کارایی On-call و مسیر Escalation | تأخیر طولانی در پذیرش مسئولیت |
| زمان بازیابی / MTTR | سرعت بازگرداندن سرویس | بازماندن مشکل پس از شناسایی |
| False Negative | خرابیهایی که هیچ هشدار مهمی نداشتهاند | کاربران پیش از تیم عملیات مشکل را گزارش میکنند |
هر هفته چند هشدار پرنویز را بررسی کنید و هر ماه چند خرابی واقعی را با خط زمانی آنها مرور کنید. اگر Incident مهمی بدون هشدار مانده، افزودن سیگنال جدید مهمتر از کمکردن پیامهاست. برای آشنایی با اصول عمومی Alerting و مدیریت نویز میتوان به فصل پایش سیستمهای توزیعشده در Google SRE Book مراجعه کرد.
مانیتورینگ سرور با Avaztek Monitoring؛ از داده تا اعلان قابلاقدام
وقتی چند سرور و سرویس داریم، نگهداری هشدارها در ابزارهای پراکنده کار عاقلانهای نیست. Avaztek Monitoring برای نمایش یکپارچه شاخصهای سرور و مدیریت رویدادها طراحی شده است. بر اساس مستندات و امکانات سامانه، بخش هشدارها از قانونهای پایه و پیشرفته، وضعیت بازیابی، Cooldown و کانالهای مختلف اعلان پشتیبانی میکند؛ امکان مشاهده متریکهای CPU، حافظه، دیسک، شبکه، سرویسها و رخدادهای مرتبط نیز در دسترس است.
از امکانات مرتبط با این مقاله میتوان به ارسال اعلان از مسیرهای ایمیل، SMS، تلگرام، بله و Webhook، مشاهده خطاها و جستجوی لاگها اشاره کرد. دسترسپذیری هر کانال و سطح تنظیمات میتواند به پیکربندی سرویس و شرایط پلن وابسته باشد؛ بنابراین برای انتخاب نهایی، امکانات و محدودیتهای جاری را در صفحه رسمی پلنهای مانیتورینگ آواتک بررسی کنید.
سه سناریوی مفید برای استفاده از سامانه مانیتورینگ آواتک
- اخطار دیسک قبل از بحران: روند رشد فضای مصرفی را ببینید و با هشدار مرحلهای، قبل از پرشدن کامل ظرفیت اقدام کنید.
- ثبت Recovery واقعی: هنگام بازگشت سرویس به حالت سالم، رسیدگیکننده را از پایان حادثه باخبر کنید؛ بهجای اینکه فقط پیام شروع خرابی دیده شود.
- اتصال هشدار به عیبیابی: اعلان را در کنار نمودارهای منابع، وضعیت سرویس و Log Explorer بررسی کنید تا لازم نباشد بین چند ابزار جابهجا شوید.
این مثالها رویکرد استفاده از قابلیتهای پایش و هشدار را نشان میدهند و به معنی تنظیم خودکار یک قانون مشخص بدون اقدام کاربر نیستند.
شروع استفاده از مانیتورینگ آواتک
برای ارزیابی راهکار، وارد سامانه Avaztek Monitoring شوید، امکانات سرویس را ببینید و از مسیر ایجاد حساب شروع کنید. توصیه میشود ابتدا چند هشدار واقعاً مهم برای سرویس حیاتی خود بسازید، پیام آزمایشی دریافت کنید و بعد از مشاهده رفتار عادی، سطحبندی و Cooldown را تنظیم کنید.
سؤالات متداول درباره هشدار مانیتورینگ سرور
چرا با وجود مانیتورینگ سرور هنوز قطعی را دیر میفهمیم؟
ممکن است فقط متریک منابع ثبت شود، نه تجربه واقعی کاربر؛ یا آستانهها آنقدر نویز داشته باشند که پیام مهم نادیده گرفته شود. برای رفع مشکل، SLI مرتبط با سرویس، مسئول هشدار، کیفیت اعلان و تست دورهای را بررسی کنید.
بهترین آستانه هشدار CPU چند درصد است؟
مقدار جهانی واحدی وجود ندارد. نوع سرور، تعداد هسته، الگوی بار، مدت افزایش و اثر روی درخواستهای کاربران تعیینکنندهاند. پیشنهاد میشود بهجای یک عدد ثابت، از خط پایه، پنجره زمانی و ترکیب با تأخیر سرویس استفاده شود.
تفاوت Cooldown و Recovery در مانیتورینگ چیست؟
Cooldown مدت یا شرایط جلوگیری از اعلان تکراری را مشخص میکند؛ Recovery نشان میدهد مشکل پس از بازگشت پایدار شاخصها تمام شده است. برای تشخیص درست حادثه، هر دو مورد مفیدند.
آیا هنگام Deploy باید همه هشدارها خاموش شوند؟
خیر. برای تغییر برنامهریزیشده میتوان Maintenance Window محدود تعریف کرد، اما مسیرهای حیاتی مثل پرداخت و دیتابیس باید همچنان پایش شوند. Readiness برنامه را نیز از بررسیهای صرفاً جانبی جدا کنید.
چطور بفهمیم یک هشدار ارزش اعلان فوری دارد؟
سه عامل را بررسی کنید: اثر مستقیم بر کاربر، فوریت اقدام و امکان انجام کار مشخص توسط فرد دریافتکننده. اگر فقط یک نمودار بالا رفته ولی هیچ اقدامی لازم نیست، آن رویداد شاید برای گزارش دورهای مناسبتر باشد.
آیا مانیتورینگ آواتک اعلان چندکاناله دارد؟
بله؛ در مستندات سامانه کانالهایی مانند ایمیل، پیامک، تلگرام، بله و Webhook معرفی شدهاند. دسترسی و نحوه پیکربندی هر کانال را در سرویس و پلن فعلی بررسی کنید.
برای تکمیل مسیر یادگیری، تحلیل ظرفیت و پیشبینی کمبود منابع نشان میدهد چطور قبل از بحران ظرفیت هشدار بدهید؛ مانیتورینگ واقعی قطعی وبسایت از دید کاربر هم به تشخیص هشدارهای مرتبط با شبکه کمک میکند.
جمعبندی؛ مانیتورینگ سرور وقتی ارزشمند است که هشدار آن قابل اعتماد باشد
از تعداد اعلانها شروع نکنید؛ از کیفیت تصمیم شروع کنید. آستانه مناسب، زمان تداوم، Hysteresis، Deduplication، گروهبندی رخدادها، اولویتبندی بر اساس اثر بر کاربر و پیام Recovery باعث میشوند مانیتورینگ سرور به ابزار عملیاتی واقعی تبدیل شود. برای تجربه یک داشبورد یکپارچه و بررسی امکانات هشدار، Avaztek Monitoring را ببینید و مطابق نیاز زیرساخت خود برنامه هشدار بسازید.
نظرات و گفتوگو
نظرها پس از تایید مدیر منتشر میشوند. پاسخهای رسمی مدیر با نشان مشخص نمایش داده میشوند.