
بکاپ سبز بود، بازیابی شکست خورد! مانیتورینگ سرور برای روز بحران
آیا بکاپ سرور واقعاً قابل بازیابی است؟ بررسی تفاوت RPO و RTO، آزمون Restore، سلامت فایل پشتیبان، فضای مقصد و هشدار شکست بکاپ همراه با راهکارهای مانیتورینگ سرور.
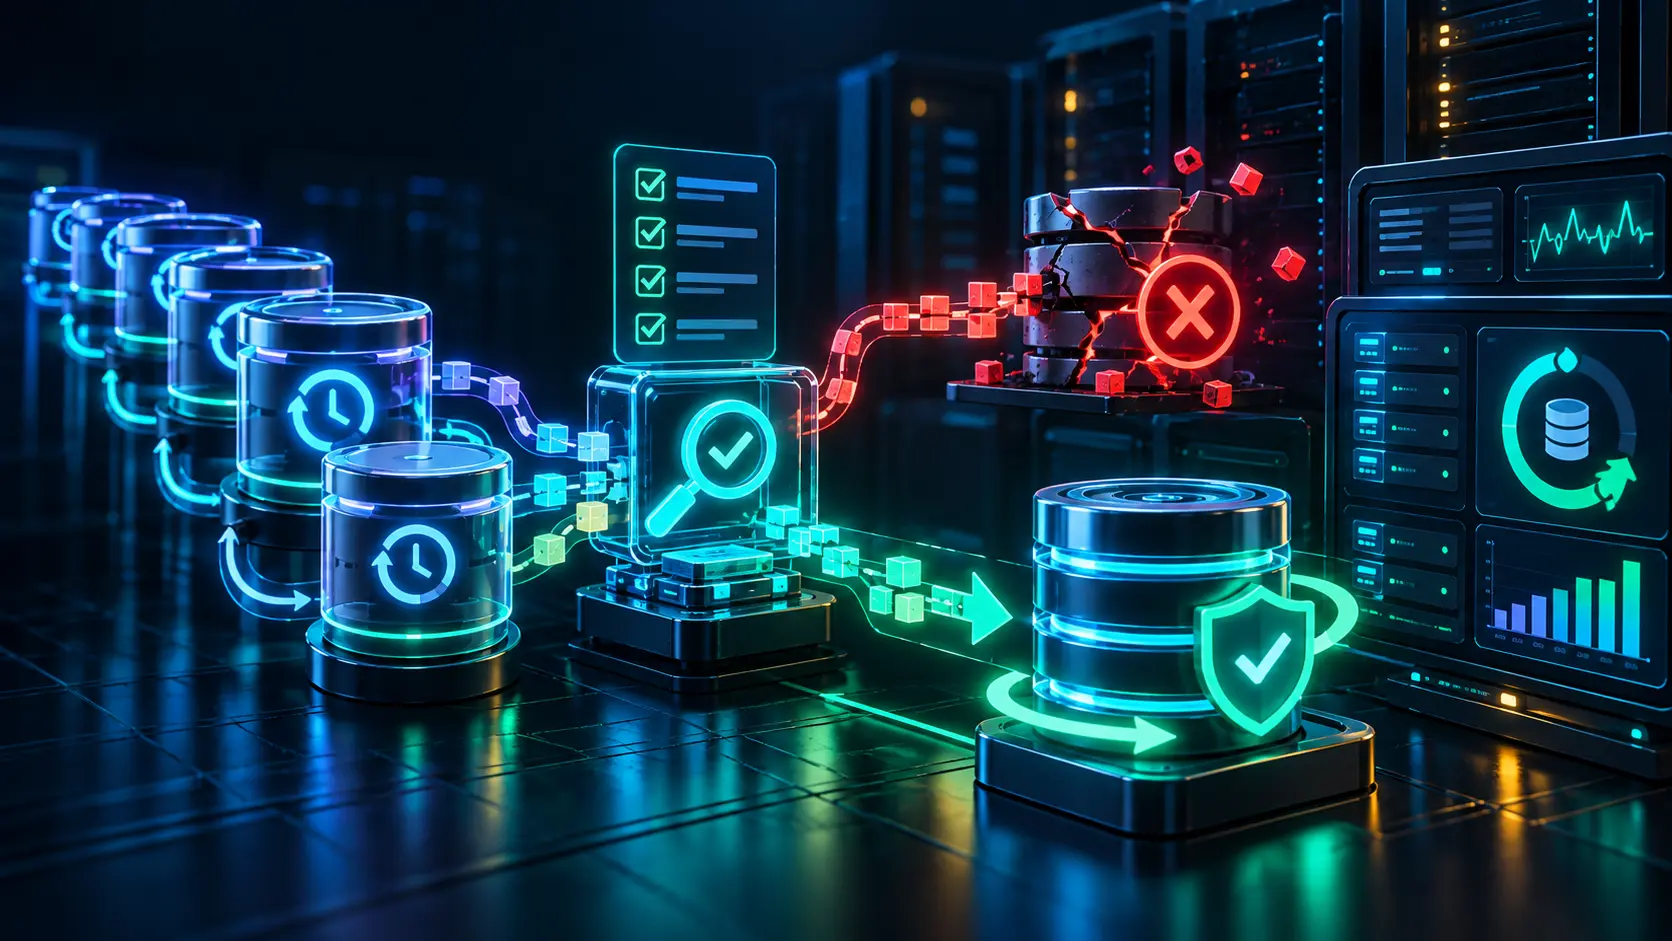
هر شب ساعت دو یک پیام سبز میآید: «بکاپ با موفقیت انجام شد». همهچیز آرام است تا روزی که دیتابیس آسیب میبیند و معلوم میشود فایل پشتیبان سه هفته است ناقص ذخیره شده، رمز آن در دسترس نیست یا بازگردانی آن بیش از زمان قابلقبول طول میکشد. اینجا مشکل فقط بکاپگیری نیست. مانیتورینگ سرور باید بتواند میان «فرایند بکاپ اجرا شد» و «از این نسخه میتوان سرویس را بازیابی کرد» تفاوت بگذارد.
در این مقاله درباره پایش سلامت نسخه پشتیبان، سن آخرین بکاپ قابل بازیابی، آزمون Restore، شاخصهای RPO و RTO و طراحی هشدار صحبت میکنیم. بحث نصب یک نرمافزار بکاپ یا انتخاب فضای ذخیرهسازی نیست؛ هدف این است که هنگام خرابی واقعی، تیم فنی بداند چه دادهای در اختیار دارد، چقدر ممکن است از دست برود و بازیابی احتمالاً چقدر زمان میخواهد.
چرا موفقبودن Job بکاپ تضمین بازیابی نیست؟
Job ممکن است با کد خروج صفر تمام شود، اما فایل روی مقصد اشتباه ذخیره شده باشد؛ یا دیتابیس در زمانی ناسازگار کپی شده باشد و نسخه بهدستآمده قابل بازیابی نباشد. گاهی فایل سالم است ولی کلید رمزگذاری، مجوز دسترسی یا دستورالعمل بازگردانی در دسترس نیست. بنابراین تعریف «بکاپ سالم» به چند شواهد نیاز دارد: فایل کامل، متناسب با نوع داده، قابل خواندن، با نسخه و تاریخ مشخص و دستکم یک بار بازیابی موفق در محیط آزمایشی.
گزارش موفقیت ابزار بکاپ یک نشانه است، نه اثبات نتیجه. اگر فایل تنها در همان سروری ذخیره شود که قرار است از خرابی آن محافظت کند، حتی آزمون موفق هم خطر از دست رفتن همزمان نسخه اصلی و پشتیبان را از بین نمیبرد.
پنج مرحلهای که باید برای بکاپ پایش شوند
- شروع بهموقع فرایند: Job در زمان مقرر اجرا شده است؟
- تکمیل بدون خطا: پردازش با وضعیت معتبر تمام شده و حجم فایل معقول است؟
- انتقال به مقصد: فایل در محل نگهداری مستقل ثبت شده است؟
- صحت داده: Hash یا سازوکار یکپارچگی با نسخه مورد انتظار تطابق دارد؟
- بازیابی آزمایشی: داده در محیط ایزوله بازگردانی شده و آزمون کاربردی را گذرانده است؟
در گزارش وضعیت، هر مرحله باید تاریخ، نتیجه و علت شکست جداگانه داشته باشد. تنها اگر فرایند پایش این دادهها را جمعآوری میکند میتوان نتیجه مناسب را روی داشبورد نشان داد؛ صرف نصب Agent مانیتورینگ به معنی وجود خودکار آزمون بازیابی نیست.
تفاوت RPO و RTO با یک مثال واقعی
RPO یا «نقطه بازیابی هدف» حداکثر فاصله زمانی دادههایی است که سازمان حاضر است هنگام حادثه از دست بدهد. RTO یا «زمان بازیابی هدف» مدت هدفگذاریشده برای بازگرداندن سرویس پس از اختلال است. این دو شاخص را باید پیش از بحران با صاحب کسبوکار تعیین کرد؛ عدد مناسب برای وبلاگ شخصی لزوماً مناسب سامانه مالی نیست.
فرض کنید سفارشها هر پنج دقیقه در نسخه قابل بازگردانی ثبت میشوند و RPO برابر ۱۵ دقیقه تعیین شده است. اگر آخرین نسخه معتبر مربوط به ۴۰ دقیقه قبل باشد، حتی اگر Job فعلی «در حال اجرا» باشد، از هدف RPO خارج شدهایم. حالا اگر بازگردانی کامل دیتابیس و راهاندازی برنامه ۹۰ دقیقه طول بکشد ولی RTO سازمان ۳۰ دقیقه باشد، برنامه عملیاتی باید بازبینی شود.
| شاخص | پرسش عملی | روش سنجش |
|---|---|---|
| RPO | چقدر از دادههای جدید ممکن است از دست برود؟ | فاصله حادثه تا آخرین نقطه بازیابی معتبر |
| RTO | سرویس چه زمانی دوباره قابل استفاده میشود؟ | زمان آزمون بازیابی تا تأیید عملیات کلیدی |
| Backup Age | آخرین بکاپ معتبر چند ساعت پیش گرفته شده؟ | زمان اکنون منهای زمان آخرین نسخه قابل تأیید |
| Restore Success | آیا نسخه واقعاً باز میشود و برنامه کار میکند؟ | بازیابی ایزوله + آزمون داده و سرویس |
دقت کنید سن فایل آخرین بکاپ با RPO واقعی یکسان نیست؛ قابلیت Point-in-Time Recovery، لاگ تراکنش و نحوه هماهنگی Snapshot با برنامه میتوانند نقطه بازیابی متفاوتی ایجاد کنند.
کدام هشدارها برای نسخه پشتیبان ارزش دارند؟
سادهترین قانون، «بکاپ اجرا نشد» است. این قانون کافی نیست. بهتر است حداقل زمان آخرین نسخه معتبر، مدت اجرای Job، حجم نسبت به بازه معمول، وضعیت انتقال مقصد، ظرفیت فضای نگهداری، انقضای کلید یا دسترسی لازم و نتیجه آخرین Restore آزمایشی بررسی شوند. اگر یک بکاپ نسبت به نسخههای گذشته ناگهان بسیار کوچک شده است، صرف کاملشدن آن نباید باعث سبزشدن وضعیت شود.
هشدار را بر اساس اهمیت داده تنظیم کنید
برای دیتابیس سفارشها شاید عبور از RPO هدف نیازمند رسیدگی فوری باشد؛ اما برای آرشیو عکسهای قدیمی، یک گزارش روزانه کفایت کند. معیار درست «ضرر احتمالی ازدسترفتن داده و زمان بازیابی» است. با استفاده از اصول هشدار هوشمند مانیتورینگ سرور میتوان پیامهای تکراری یک Job خراب را گروهبندی کرد و بعد از بازیابی معتبر، Recovery ارسال کرد.
روش درست آزمون بازیابی بدون دستکاری Production
آزمون Restore باید در محیط مستقل انجام شود. بازگرداندن مستقیم نسخه آزمایشی روی دیتابیس اصلی میتواند داده مشتریان را پاک کند؛ بنابراین محل آزمون و مجوز دسترسی را قبل از شروع مشخص کنید.
- یک نسخه پشتیبان مشخص با شناسه و تاریخ بردارید، بدون اینکه نسخه اصلی آن حذف شود.
- کلید رمزگذاری و حساب دسترسی را بهصورت کنترلشده در اختیار فرایند آزمون قرار دهید.
- در یک سرور یا محیط جداگانه، نسخه را بازیابی کنید؛ دسترسی شبکه آن را محدود نگه دارید.
- یکپارچگی ساختار جدولها، تعداد رکوردها و چند مسیر واقعی اما غیرمخرب برنامه را بررسی کنید.
- مدت زمان Restore، خطاها و مراحل دستی را ثبت کنید و با RTO مقایسه کنید.
- پس از پایان، داده آزمایشی را طبق سیاست محرمانگی حذف کنید و گزارش را نگه دارید.
نمونههای پشتیبان ممکن است حاوی اطلاعات شخصی باشند. ایزولهسازی و کنترل مجوز در محیط آزمون همانقدر مهم است که صحت فایل. اگر به داده واقعی برای آزمون نیاز ندارید، از نسخه ناشناسسازیشده یا Fixtureهای معتبر استفاده کنید.
سیاست ۳-۲-۱ چه کمکی میکند و کجا کافی نیست؟
الگوی شناختهشده ۳-۲-۱ پیشنهاد میکند چند نسخه از داده روی رسانهها یا مسیرهای مستقل نگه دارید و دستکم یک نسخه از محل اصلی جدا باشد. این الگو راهنمای طراحی است، نه ضمانت مصونیت از باجافزار، حذف اشتباهی یا اختلال همزمان. نسخهای که از نظر شبکه و حساب دسترسی دقیقاً همان مجوزهای Production را دارد ممکن است همراه با نسخه اصلی از بین برود.
برای داده حیاتی، جداکردن حساب نگهداری بکاپ، محدودکردن حذف نسخهها، فعالسازی قفل نگهداری در صورت پشتیبانی مقصد و آزمون دورهای بازیابی ضروری است. در مستند راهنمای مقابله با باجافزار CISA نیز بر برنامه بازیابی و نگهداری نسخههای محافظتشده تأکید شده است. نسخههای مستقل را بهصورت عملی آزمایش کنید، نه صرفاً با دیدن نام فایلها.
چرا نسخه پشتیبان دیتابیس با کپیکردن فایل فرق دارد؟
دیتابیس در زمان کار دائماً داده و لاگ تراکنش مینویسد. کپی ساده فایلهای آن در حین فعالیت، بدون رعایت سازوکار رسمی موتور، ممکن است نسخهای ناسازگار بسازد. برای MySQL، PostgreSQL و سایر پایگاهدادهها از روش پشتیبانیشده همان موتور یا ابزار سازگار با آن استفاده کنید. برای قابلیت بازیابی تا لحظه مشخص، نگهداری زنجیره کامل لاگهای لازم و آزمون بازگرداندن آن اهمیت دارد.
برای پایش بکاپ دیتابیس چه چیزی را ثبت کنیم؟
شناسه Job، زمان شروع و پایان، نوع بکاپ کامل یا افزایشی، مقصد، اندازه، نتیجه بررسی یکپارچگی و شناسه Restore آزمایشی را نگه دارید. اگر از بکاپ افزایشی استفاده میکنید، سالمبودن آخرین فایل کافی نیست؛ وابستگی به نسخه پایه و همه قطعههای زنجیره باید کنترل شود.
یک سناریوی واقعیتر: وقتی فضای مقصد پر میشود
فرض کنید فایلهای نسخه پشتیبان روزانه تولید میشوند و فضای مقصد به ۹۲٪ رسیده است. ابزار بکاپ ممکن است قبل از پایان انتقال خطا بدهد، ولی روی سرور اصلی همچنان یک فایل موقت وجود داشته باشد. اگر داشبورد فقط وجود فایل را بسنجد، هشدار اشتباهی سبز میشود.
برای پیشگیری، هم نتیجه فرایند و هم فضای آزاد مقصد را پایش کنید. حجم نهایی فایل را با بازه معمول مقایسه کنید و پس از انتقال، بررسی یکپارچگی را انجام دهید. اگر مقصد در شبکه دیگری قرار دارد، موفقیت اتصال و کاملشدن انتقال دو وضعیت مستقلاند. راهنمای پیشبینی ظرفیت منابع سرور نشان میدهد چگونه روند مصرف فضای ذخیرهسازی را پیش از بحرانیشدن بررسی کنید.
جدول تصمیم برای چهار نوع حادثه داده
| حادثه | اولین اقدام کمخطر | ریسک بازیابی |
|---|---|---|
| حذف تصادفی یک جدول | توقف تغییرات آسیبزا و حفظ شواهد | بازنویسی داده جدید هنگام بازگردانی مستقیم |
| خرابی دیسک دیتابیس | ثبت وضعیت و فعالسازی برنامه جایگزین | ناقصبودن زنجیره Snapshot و لاگ تراکنش |
| باجافزار | ایزولهسازی سیستم آلوده با هماهنگی تیم امنیت | آلوده یا حذفشدن بکاپ متصل با همان مجوز |
| اشتباه در Deploy | توقف انتشار و بررسی قابلیت Rollback | ناسازگاری نسخه Schema با کد بازیابیشده |
هدف این جدول تشویق به اقدام خودسرانه نیست. در حادثه واقعی، تغییر سرور یا دیتابیس بدون ثبت وضعیت میتواند بازیابی و بررسی ریشه مشکل را دشوارتر کند. دستورالعمل واکنش باید از قبل آزمایش شده باشد.
چکلیست ماهانه برای مدیر سرور
- برای هر سرویس حیاتی، RPO و RTO مورد توافق ثبت شده است.
- آخرین نسخه قابل بازیابی و نتیجه آخرین آزمون Restore مشخصاند.
- نسخه پشتیبان از حساب و محل ذخیرهسازی اصلی تا حد لازم جداست.
- کلید رمزگذاری و روش دسترسی اضطراری تحت کنترل و قابل استفادهاند.
- فضای ذخیرهسازی، هزینه نگهداری و سیاست حذف نسخههای قدیمی بررسی شدهاند.
- یک نفر مسئول پیگیری هشدار شکست بکاپ و تأیید بازیابی است.
- آزمون اخیر صرفاً بررسی Hash نبوده و سلامت داده پس از Restore هم بررسی شده است.
نقش Avaztek Monitoring در پایش سرور و رخدادهای پشتیبانگیری
Avaztek Monitoring برای مشاهده منابع و رخدادهای سرور در یک محیط مرکزی طراحی شده است. طبق مستندات محصول، Agent سرور متریکهای دیسک، حافظه و سرویسها را جمعآوری میکند و قابلیت Log Explorer امکان جستوجوی رویدادهای برنامه و بررسی بازه زمانی خطاها را فراهم میسازد. برای سامانه بکاپ، این امکانات کمک میکنند فشار دیسک، اختلال سرویس یا لاگ شکست Job در کنار وضعیت کلی میزبان دیده شود، به شرط اینکه لاگ یا شاخص موردنظر در مجموعه دادههای جمعآوریشده قرار گرفته باشد.
خود مانیتورینگ جایگزین اجرای بکاپ مستقل، بررسی سلامت فایل یا تست Restore نیست. در صورتی که میخواهید نتیجه عملیات بازیابی را در پایش عملیاتی خود ببینید، ابتدا مشخص کنید ابزار بکاپ چه خروجی، Log یا شاخصی ارائه میکند و برای ثبت آن در سامانه چه اتصال یا تنظیمی لازم است. وعده بازیابی تضمینی بدون اجرای آزمون واقعی، قابل اتکا نیست.
برای بررسی امکانات جاری و انتخاب سطح مناسب پایش، صفحه پلنهای مانیتورینگ آوازتک در دسترس است. پس از بررسی نیاز، میتوانید از مسیر رسمی ثبتنام شروع کنید و ابتدا فضای مقصد بکاپ و لاگ Job مربوط را در داشبورد عملیاتی خود بررسی کنید.
پرسشهای متداول درباره مانیتورینگ بکاپ سرور
اگر بکاپ هر شب موفق شود، چرا باید Restore آزمایشی انجام دهیم؟
موفقیت Job نشان میدهد فرایند اجرا شده، اما قابل بازیابی بودن داده را ثابت نمیکند. نسخه ممکن است ناقص، ناسازگار با دیتابیس یا وابسته به کلید در دسترسنبودنی باشد. بازیابی ایزوله و آزمون کاربردی این فاصله را مشخص میکند.
بهترین فاصله زمانی بکاپ گرفتن از سرور چقدر است؟
عدد واحدی وجود ندارد. فاصله مناسب را بر اساس RPO، حجم تغییر داده و هزینه نگهداری تعیین کنید. برای دادهای با RPO چند دقیقهای، بکاپ روزانه بهتنهایی کافی نیست و ممکن است به سازوکار بازیابی نقطهای نیاز باشد.
آیا داشتن سه نسخه بکاپ به معنی امنیت کامل است؟
خیر. اگر هر سه نسخه با یک حساب قابل حذف باشند، خطر مشترک دارند. تفکیک دسترسی، مقصد مستقل، سیاست نگهداری مناسب و آزمون Restore را در کنار تعداد نسخهها در نظر بگیرید.
RPO و RTO در مانیتورینگ سرور چه فرقی دارند؟
RPO درباره نقطه زمانی داده قابل بازیابی و میزان تحمل ازدسترفتن اطلاعات است. RTO مدت قابلقبول بازگرداندن سرویس را مشخص میکند. ممکن است آخرین نسخه تازه باشد اما Restore آن ساعتها طول بکشد.
آیا سامانه مانیتورینگ آوازتک خودش بکاپ را بازیابی میکند؟
بر اساس قابلیتهای مستند فعلی، این سامانه برای پایش منابع، سرویس و لاگها معرفی شده است؛ انجام و تأیید بازیابی واقعی باید با ابزار بکاپ و فرایند آزمون مستقلی انجام شود.
اگر کندی دیتابیس باعث شکست یا طولانیشدن عملیات پشتیبانگیری میشود، راهنمای شناسایی گلوگاه دیتابیس را بخوانید. بررسی نشانههای ورود مشکوک و تغییر دسترسی نیز برای حفاظت از حسابهای دارای مجوز حذف بکاپ مفید است.
اگر هنوز با شاخصهای پایه سلامت سرور آشنا نیستید، راهنمای جامع مانیتورینگ سرور نقطه شروع مناسبی است.
جمعبندی: بکاپ قابل اعتماد باید امتحانش را پس داده باشد
اگر فردا دیتابیس حذف شود، «آخرین پیام سبز» پاسخ کافی نیست. زمان آخرین نسخه معتبر، فاصله با RPO، نتیجه Restore آزمایشی و مدت بازیابی باید روشن باشد. مانیتورینگ سرور با نمایش فشار منابع و خطاهای Job میتواند نشانههای خطر را زودتر آشکار کند، اما تصمیم نهایی به آزمون بازیابی وابسته است. برای دیدن امکانات پایش سرور و لاگها، سامانه مانیتورینگ آوازتک را بررسی کنید.
نظرات و گفتوگو
نظرها پس از تایید مدیر منتشر میشوند. پاسخهای رسمی مدیر با نشان مشخص نمایش داده میشوند.