
کاهش هزینه API هوش مصنوعی؛ کنترل توکن، کش و بودجه پروژه
کاهش هزینه API هوش مصنوعی با اندازهگیری Token، سهمیه پروژه، Rate Limit، Cache ایمن، انتخاب مدل و کنترل بودجه. فرمول محاسبه واقعی و مثال عددی با معرفی Avaztek AI.
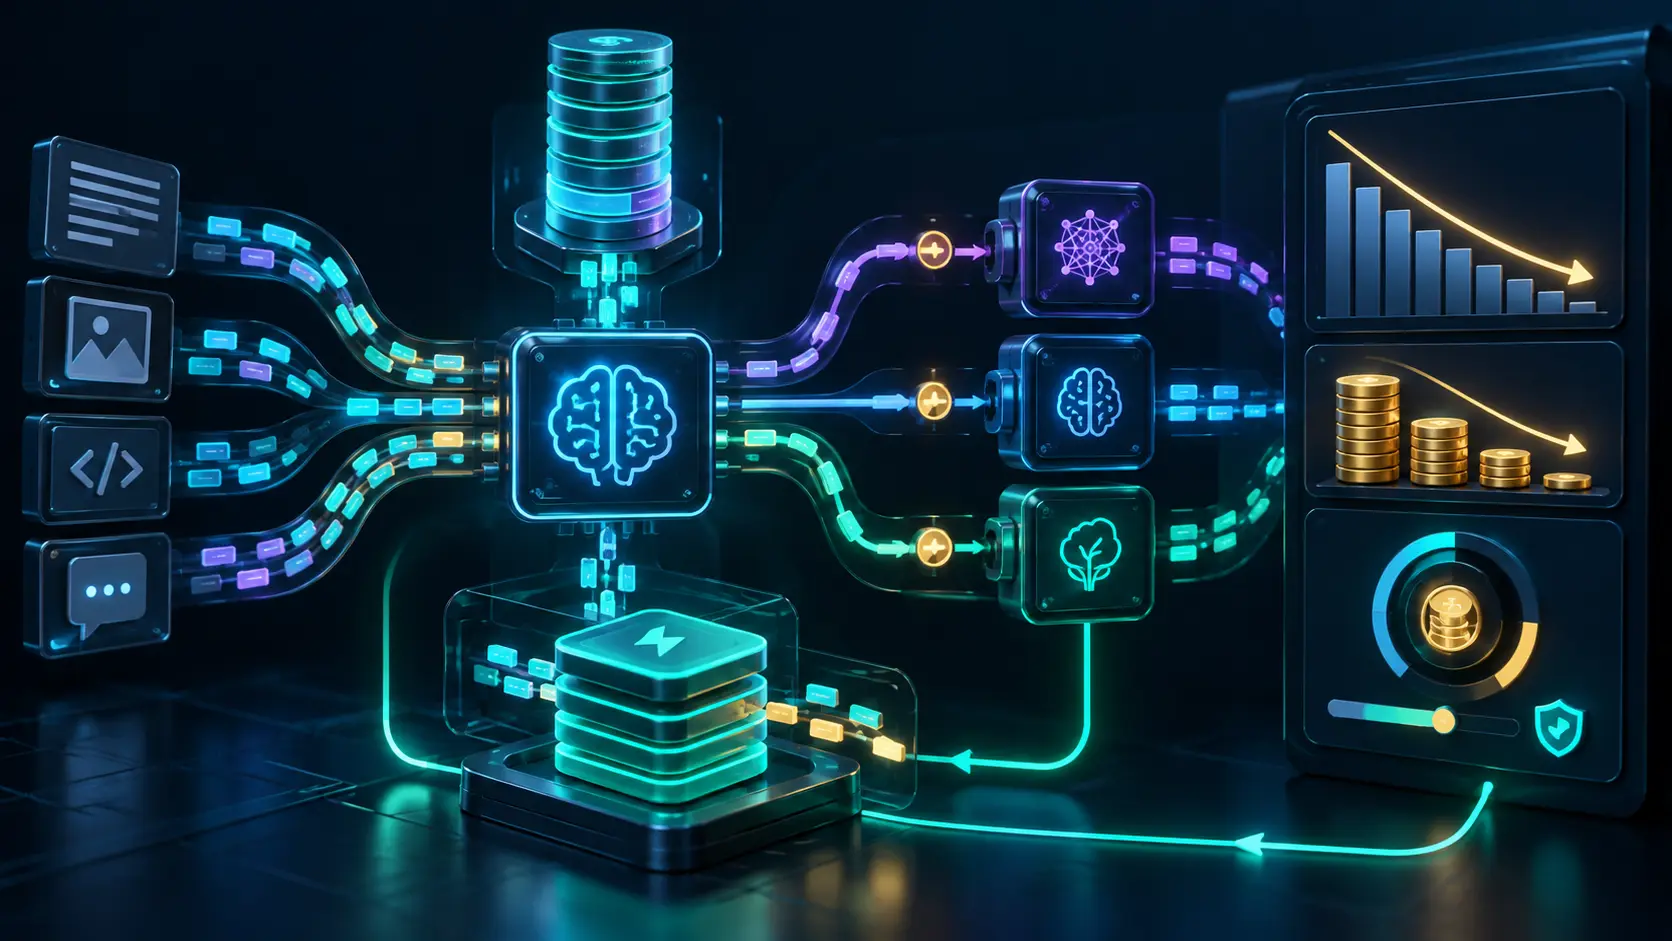
محصول شما روزانه ۸۰۰ درخواست تحلیل متن دارد و همهچیز در آزمایش خوب به نظر میرسد. اما پس از اضافهشدن چند مشتری، هزینه API هوش مصنوعی دو برابر میشود؛ بدون اینکه تعداد کاربران دو برابر شده باشد. بررسی گزارش مصرف نشان میدهد بعضی درخواستها Context قدیمی را هر بار میفرستند، پاسخ نامعتبر دوباره تولید میشود و یک Job شکستخورده چند بار مدل گرانقیمت را صدا میزند. کاهش هزینه API هوش مصنوعی در چنین موقعیتی با عوضکردن فوری مدل شروع نمیشود؛ اول باید بفهمیم هر نتیجه قابل استفاده واقعاً چند توکن و چند تلاش هزینه داشته است.
این مقاله درباره مهندسی هزینه در محصول عملیاتی است: محاسبه مصرف Token، کنترل سهمیه هر مشتری، Rate Limit، Cache، انتخاب مدل بر اساس کار، بودجه ماهانه و گزارش هزینه هر پاسخ موفق. بحث این صفحه با انتخاب بهترین API هوش مصنوعی برای برنامهنویسان ایرانی متفاوت است؛ آن مقاله به انتخاب Provider میپردازد و اینجا پس از انتخاب، مصرف و هزینه را مهار میکنیم.
هزینه API از کجا میآید و توکن دقیقاً چیست؟
بسیاری از سرویسهای مدل زبانی مصرف را بر اساس Token محاسبه میکنند. Token معادل ثابت یک حرف یا یک کلمه فارسی نیست؛ تعداد آن به مدل و Tokenizer وابسته است. ورودی درخواست میتواند شامل دستور سیستم، تاریخچه گفتگو، داده RAG و قالب ابزار باشد. خروجی نیز متن یا محتوای دیگر است و بعضی مدلها بخشهای جداگانه مصرف مانند توکن پردازش داخلی دارند.
در گزارشهای واقعی، مقدار usage یا فیلدهای معادل ارائهدهنده را بخوانید؛ «تعداد کاراکتر ÷ چهار» برای تخمین اولیه شاید وسوسهکننده باشد، اما در فارسی یا متن ترکیبی معیار حسابداری دقیق نیست. برای جزئیات قیمت، به مستندات رسمی قیمت API OpenAI و صفحه قیمت Provider مورد استفاده مراجعه کنید. نرخها و قوانین Cache یا ابزارها ممکن است تغییر کنند.
فرمول محاسبه هزینه توکن با یک مثال قابل بررسی
اگر مدل ورودی و خروجی متنی را جدا قیمتگذاری کند، برآورد پایه چنین است:
هزینه تقریبی = (توکن ورودی ÷ ۱٬۰۰۰٬۰۰۰ × نرخ ورودی) + (توکن خروجی ÷ ۱٬۰۰۰٬۰۰۰ × نرخ خروجی)
فرض کنید یک پروژه در ماه ۱۲ هزار درخواست دارد. هر درخواست بهطور متوسط ۱٬۸۰۰ توکن ورودی و ۴۵۰ توکن خروجی مصرف میکند؛ بنابراین ماهانه ۲۱٫۶ میلیون توکن ورودی و ۵٫۴ میلیون توکن خروجی داریم. برای مثال صرفاً فرضی اگر نرخ ورودی ۱ دلار و نرخ خروجی ۳ دلار بهازای هر یک میلیون توکن باشد، بخش ورودی ۲۱٫۶ دلار و بخش خروجی ۱۶٫۲ دلار خواهد شد؛ جمع پایه ۳۷٫۸ دلار است. این نرخها قیمت هیچ Provider مشخصی نیستند.
اگر ۱۰٪ درخواستها یک بار تکرار کامل داشته باشند، با فرض مصرف مشابه در Retry، هزینه فرضی به حدود ۴۱٫۵۸ دلار میرسد. هنوز هزینه فایل، ابزار، Tokenهای خاص، Cache، شبکه یا مالیات در این عدد لحاظ نشده است. مهمتر اینکه اگر بخشی از پاسخها اشتباه باشد، هزینه هر نتیجه پذیرفتهشده از هزینه هر فراخوانی بیشتر میشود.
| جزء محاسبه | سناریوی فرضی ماهانه | نکته |
|---|---|---|
| تعداد درخواست | ۱۲٬۰۰۰ | قبل از Retry |
| توکن ورودی | ۲۱٫۶ میلیون | ۱٬۸۰۰ × تعداد درخواست |
| توکن خروجی | ۵٫۴ میلیون | ۴۵۰ × تعداد درخواست |
| هزینه پایه فرضی | ۳۷٫۸ دلار | با نرخ نمونه ۱ و ۳ دلار |
| هزینه با ۱۰٪ Retry کامل | ۴۱٫۵۸ دلار | در صورت نبود تغییر مدل یا نرخ |
اولین گام کاهش هزینه: گزارش مصرف را دقیق ثبت کنید
برای هر درخواست حداقل شناسه پروژه، شناسه مدل، زمان شروع و پایان، وضعیت موفق یا ناموفق، توکنهای ورودی و خروجی گزارششده، تعداد تلاشها و هزینه محاسبهشده را نگه دارید. برای درخواست صفی، request_id پایدار باعث میشود اجرای مجدد در گزارش دوبار به عنوان یک سفارش مستقل شمرده نشود. البته ممکن است Provider برای هر تلاش واقعاً هزینه بگیرد؛ هزینه مصرف را باید از شناسه کسبوکار تفکیک کرد.
اگر Provider مقدار Usage را در پاسخ خطا نمیدهد، عدد دقیق مصرف همان تلاش نامعلوم است. آن را «صفر» فرض نکنید و با برآورد جداگانه علامت بزنید. در گزارش ماهانه دو ستون داشته باشید: مصرف تأییدشده و مصرف برآوردی. برای تسویه یا بودجه حساس، داده صورتحساب Provider معیار معتبرتری از محاسبه محلی است.
کنترل بودجه برای هر پروژه با Rate Limit فرق دارد
Rate Limit میگوید در یک بازه زمانی چند درخواست مجاز است؛ Quota مقدار مصرف یک دوره را محدود میکند؛ و Budget سقف هزینه قابل قبول است. ممکن است مشتری در یک دقیقه تنها دو درخواست بدهد، اما هر درخواست بسیار طولانی و گران باشد. پس محدودکردن تعداد درخواست، سقف هزینه را تضمین نمیکند.
| کنترل | چه چیزی را محدود میکند؟ | برای چه مسئلهای؟ | محدودیت |
|---|---|---|---|
| Rate Limit | تعداد درخواست در زمان | پیشگیری از Burst و سوءاستفاده | اندازه درخواست را نمیسنجد |
| Token Quota | توکن مصرفی پروژه در دوره | سهمیهبندی میان مشتریان | نرخ توکن مدلهای مختلف یکسان نیست |
| Budget | هزینه محاسبهشده یا رزروشده | کنترل مالی و سقف ماهانه | تأخیر گزارش Usage یا Retry میتواند اختلاف ایجاد کند |
| Concurrency Limit | تعداد اجرای همزمان | حفظ Worker و ظرفیت Provider | بهتنهایی مصرف کل را کم نمیکند |
چرا قبل از اجرای درخواست باید بودجه را رزرو کنیم؟
فرض کنید از بودجه مشتری ۱۰ واحد باقی مانده و پنج Worker همزمان هر کدام میخواهند ۴ واحد مصرف کنند. اگر همه ابتدا «مانده بودجه» را بخوانند و بعد اجرا شوند، ممکن است هر پنج درخواست پذیرفته شوند. باید در یک عملیات اتمیک، هزینه تخمینی را رزرو کنید و پس از دریافت Usage واقعی آن را تسویه کنید؛ رزرو مازاد آزاد شود و مصرف بیش از برآورد طبق سیاست سقف ثبت شود.
BEGIN TRANSACTION
  Lock the tenant budget row
  Verify: available_budget >= estimated_max_cost
  Reserve estimated_max_cost; create request record
COMMIT
Execute the model call outside the database transaction
Reconcile reservation with actual metered usage
این الگوریتم شبهکد است، نه دستور قابل اجرا روی دیتابیس مشخص. قفل دیتابیس نباید تا پایان تماس چندثانیهای با Provider نگه داشته شود. برای خطای Worker، قطع شبکه و درخواست بیپاسخ نیز باید وضعیت رزرو معلق و سیاست آزادسازی یا تطبیق بعدی تعریف شود.
روش دوم: کاهش توکن ورودی بدون از بین بردن کیفیت پاسخ
در بسیاری از محصولات، هزینه از تاریخچه گفتوگو و دادههای تکراری رشد میکند. برای هر درخواست، Context لازم را مشخص کنید. اگر پاسخ درباره سفارش فعلی است، ارسال همه مکالمات شش ماه گذشته کمکی نمیکند. به جای حذف تصادفی متن، ابتدا رفتار مدل را با مجموعه آزمون ثابت بسنجید.
- از سیستمپرامپت کوتاه، واضح و بدون دستورهای تکراری استفاده کنید.
- تاریخچه مکالمه را با سیاست مشخص خلاصه کنید و خطاهای خلاصهسازی را بسنجید.
- در RAG، اسناد را بخشبندی و فقط قطعات مرتبط با پرسش را بازیابی کنید.
- Schema خروجی را تا حد لازم محدود کنید و فیلدهای بیمصرف را نفرستید.
- پیش از فراخوانی مدل، ورودیهای نامعتبر و درخواستهای تکراری واضح را در Backend رد کنید.
برای مثال فرضی، اگر هر درخواست بهجای ۴۰۰۰ توکن تاریخچه، فقط ۱۲۰۰ توکن مرتبط داشته باشد، ۲۸۰۰ توکن ورودی کمتر ارسال میشود. اما تنها در صورتی این صرفهجویی ارزش دارد که دقت پاسخ افت نکند. ابتدا کیفیت را با داده واقعی تأیید کنید، سپس سیاست را گسترش دهید.
اگر این کنترلها را در Laravel میسازید، ابزار Rate Limiting لاراول برای محدودسازی تعداد درخواست کاربرد دارد، ولی Quota توکن و رزرو بودجه نیاز به منطق جدا و داده پایدار دارند. برای Cache هم مستندات Cache لاراول را بررسی کنید؛ وابستگی به Cache ناپایدار بدون سیاست شکست میتواند جریان پرداخت یا سهمیه را مختل کند.
روش سوم: Cache را برای درخواستهای واقعاً قابل تکرار فعال کنید
اگر مشتری چند بار درباره ساعات کاری فروشگاه سؤال میکند و پاسخ از اطلاعات عمومی ثابت ساخته میشود، اجرای مدل در هر بار لزوماً ضروری نیست. Cache نتیجه میتواند زمان پاسخ و هزینه را کاهش دهد؛ اما برای اطلاعات شخصی، قیمت لحظهای یا درخواست وابسته به حساب کاربر، کلید و طول عمر Cache باید با دقت طراحی شود.
کلید Cache چه دادههایی داشته باشد؟
معمولاً نسخه Prompt، مدل، پارامترهای مؤثر بر پاسخ، زبان، نسخه منبع داده و در صورت شخصیبودن، شناسه Tenant باید در تعریف کلید لحاظ شوند. اگر فقط متن سؤال را Hash کنید، پاسخ مربوط به مشتری A ممکن است برای مشتری B برگردد. استفاده از Cache مشترک بدون جداسازی داده محرمانه خطر نشت اطلاعات دارد.
برای پرسشهای عمومی میتوان TTL کوتاه یا Invalidation هنگام تغییر محتوای منبع داشت. برای داده حساس بهتر است Cache پیشفرض خاموش باشد، مگر اینکه مجوز و هدف مشخصی وجود داشته باشد. Cache خروجی برنامه با Prompt Caching سمت Provider یکی نیست؛ نوع دوم تنها در صورت پشتیبانی مدل و شرایط رسمی سرویس قابل استفاده است و صورتحساب متفاوتی دارد.
روش چهارم: مدل مناسب هر کار را انتخاب کنید
برای تشخیص نوع تیکت پشتیبانی، ممکن است یک مدل کوچکتر با کیفیت قابل قبول کافی باشد؛ اما تحلیل حقوقی سند یا پاسخ به پرسش حساس به دقت بالاتری نیاز داشته باشد. به جای فرستادن تمام درخواستها به گرانترین مدل، کارها را با مجموعه آزمون دستهبندی کنید. معیار انتخاب هزینه هر نتیجه صحیح است، نه اسم تجاری مدل یا یک بنچمارک عمومی.
| نوع کار | استراتژی قابل آزمایش | ریسک مهم |
|---|---|---|
| طبقهبندی تیکت ساده | مدل سبکتر یا منطق قطعی پیشپردازش | خطا در تشخیص تیکت فوری |
| استخراج ساختارمند فاکتور | مدل سازگار با خروجی JSON و Schema محدود | خطای مبلغ، تاریخ یا واحد پول |
| خلاصهسازی متن بلند | کاهش Context و Chunking کنترلشده | حذف نکته مهم از سند |
| پاسخ به موضوع حساس | مدل دقیقتر با ارزیابی انسانی مناسب | کیفیت و مسئولیت خروجی |
| پرسش عمومی تکراری | Cache ایمن و پاسخ مبتنی بر داده ثابت | نمایش اطلاعات قدیمی |
وقتی گزینه جایگزین استفاده میکنید، دسترسی قانونی، سازگاری ویژگیها، سیاست داده و کیفیت خروجی را از قبل بررسی کنید. تغییر خودکار Provider هنگام Timeout بدون این کنترلها میتواند هزینه و ریسک امنیتی را بیشتر کند. برای مفهوم مسیریابی چندمدلی، راهنمای معماری AI Gateway را بخوانید.
روش پنجم: Retry را از حلقه هزینهساز خارج کنید
همه خطاها مناسب Retry نیستند. خطای ۴۰۱ یا ۴۰۳ معمولاً به کلید یا مجوز مربوط است و تکرار درخواست همان وضعیت را تغییر نمیدهد. خطای ۴۲۹ ممکن است به Rate Limit یا Quota وابسته باشد و به زمان انتظار توصیهشده نیاز داشته باشد. برخی ۵xx و Timeoutها گذرا هستند؛ اما اگر Provider درخواست قبلی را انجام داده و پاسخ در شبکه گم شده باشد، اجرای دوباره احتمال مصرف تکراری دارد.
- برای Retry، تعداد تلاش و سقف تأخیر تعیین کنید؛ Backoff و Jitter از Burst همزمان جلوگیری میکنند.
- شناسه درخواست داخلی و در صورت پشتیبانی Provider، شناسه Idempotency را ثبت کنید.
- هر تلاش را جدا در گزارش مصرف ببینید؛ هزینه درخواست ناموفق را خودکار صفر فرض نکنید.
- برای صف معطل، Timeout، Circuit Breaker و وضعیت قابل پیگیری تعریف کنید.
- اگر خروجی نامعتبر است، قبل از اجرای دوباره بررسی کنید آیا اعتبارسنجی و Prompt را باید اصلاح کرد یا نه.
در مثال عددی ابتدای مقاله، ۱۰٪ Retry کامل حدود ۳٫۷۸ دلار به هزینه فرضی اضافه کرد. صرفهجویی در همان درخواستهای تکراری گاهی از تعویض Provider سادهتر و کمریسکتر است.
روش ششم: Batch و اجرای ناهمزمان را آگاهانه استفاده کنید
اگر کاربر منتظر پاسخ فوری نیست، درخواستها میتوانند در Queue ثبت و زمانبندی شوند. برخی Providerها برای Batch یا پردازش غیرهمزمان شرایط قیمتگذاری ویژه دارند؛ وجود یا میزان تخفیف باید از مستندات همان مدل بررسی شود. تبدیل کار به Batch، بهخودیخود تخفیف یا سرعت بیشتر را تضمین نمیکند.
برای نمونه، تحلیل شبانه ۲۰۰۰ نظر مشتری به زمان پاسخ زیر دو ثانیه نیاز ندارد. میتوان آن را در صف با شناسه پایدار و گزارش پیشرفت اجرا کرد، خطاها را جدا ثبت و پاسخ را بعد از تکمیل نمایش داد. این روش جلوی Timeout درخواست وب را میگیرد؛ ولی همچنان باید سهمیه مصرف و سقف تعداد Job همزمان را رعایت کرد.
چه داشبوردی برای کنترل هزینه هوش مصنوعی لازم داریم؟
یک صفحه مالی مفید باید هزینه را به تفکیک مشتری، پروژه، مدل و نوع کار نشان دهد؛ علاوه بر آن نرخ خطا، درصد Retry، Cache Hit و متوسط هزینه هر نتیجه قابل استفاده مهماند. اگر داشبورد فقط «تعداد درخواست» را نشان دهد، مصرف طولانیمدت یک کاربر پرمصرف پنهان میماند.
برای نمونه، دو پروژه هر کدام هزار درخواست دارند؛ اما پروژه اول در هر درخواست ۲۰۰ توکن و پروژه دوم ۴۰۰۰ توکن مصرف میکند. برابر بودن تعداد درخواستها به معنی برابر بودن هزینه نیست. تعریف هشدار در ۵۰٪، ۸۰٪ و ۹۵٪ بودجه ماهانه صرفاً یک پیشنهاد شروع است؛ مقدار مناسب را با درآمد پروژه و هزینه قابل قبول تنظیم کنید.
Avaztek AI چگونه به مدیریت مصرف چند پروژه کمک میکند؟
Avaztek AI طبق مستندات فعلی محصول، درگاه نسخهبندیشده /api/v1، API Key پروژه، تعریف Quota، گزارش Usage و Limit، مدیریت Provider/Model، پروفایل Auto Switch و پردازش صفمحور دارد. این امکانات برای تیمی که چند محصول به مدلهای مختلف وصل کرده مفیدند؛ داده مصرف و سیاست دسترسی میتوانند بهجای پراکندگی در کد هر پروژه، در یک لایه هماهنگ شوند.
اما وجود داشبورد Usage به معنای کاهش خودکار صورتحساب نیست. نرخهای واقعی Provider، نحوه محاسبه ابزارهای جانبی و انحراف رزرو از هزینه نهایی باید برای پروژه بررسی شوند. همچنین گزینه Failover نباید به مدلی نامجاز یا نامتناسب با داده حساس منتقل شود. برای جزئیات اتصال، راهنمای API و SDK آوازتک را بخوانید.
اگر نیاز به کنترل مصرف چند سایت یا پروژه دارید، نوع کار، حجم تقریبی درخواست و مدلهای مدنظرتان را از طریق فرم درخواست بررسی اتصال Avaztek AI ارسال کنید. رمز API و اطلاعات مشتری را در فرم قرار ندهید.
چکلیست عملی برای کاهش هزینه API در ۱۴ روز
- روزهای اول تا سوم: Usage واقعی، نرخ خطا و تعداد Retry را به تفکیک پروژه ثبت کنید.
- روزهای چهارم تا ششم: درخواستهای پرتکرار، Context اضافی و پاسخهای نامعتبر را جدا تحلیل کنید.
- روزهای هفتم و هشتم: روی یک گروه آزمایشی، Cache ایمن و کوتاهکردن Context را با کنترل کیفیت پیاده کنید.
- روزهای نهم تا یازدهم: مدل سبکتر را فقط برای کارهای مناسب در آزمون A/B مقایسه کنید.
- روزهای دوازدهم و سیزدهم: Quota، رزرو بودجه و هشدار مصرف را به تفکیک مشتری آزمایش کنید.
- روز چهاردهم: هزینه هر خروجی صحیح، نرخ شکست و تأخیر را با دوره پایه مقایسه کنید؛ فقط تغییر مؤثر را گسترش دهید.
آزمون A/B باید نمونهها و حجم مشابه داشته باشد. اگر کیفیت یا امنیت افت کند، صرفهجویی ظاهری ارزش حفظ تغییر را ندارد.
پرسشهای متداول درباره کاهش هزینه API هوش مصنوعی
آیا هر چهار کاراکتر فارسی یک توکن حساب میشود؟
خیر. تعداد Token به Tokenizer و مدل بستگی دارد. برای محاسبه دقیق از Usage واقعی یا ابزار رسمی شمارش Token همان Provider استفاده کنید و فرمول مبتنی بر تعداد کاراکتر را معیار صورتحساب نگذارید.
چرا Rate Limit بهتنهایی بودجه را حفظ نمیکند؟
چون تعداد درخواست را محدود میکند، نه طول ورودی یا قیمت مدل را. یک درخواست با Context طولانی ممکن است بیش از چند درخواست کوتاه هزینه داشته باشد؛ بنابراین Quota توکن و سقف هزینه هم لازماند.
آیا Cache همیشه هزینه AI را کم میکند؟
فقط وقتی نتیجه قابل استفاده مجدد باشد و هزینه ذخیره و Invalidation منطقی بماند. برای پاسخ شخصی، قیمت لحظهای یا داده حساس، Cache اشتباه میتواند خطر امنیتی و اطلاعات نادرست ایجاد کند.
چطور بهترین مدل ارزانتر را انتخاب کنیم؟
نمونههای واقعی و مجاز پروژه را با چند مدل آزمایش کنید و هزینه کل را بر تعداد نتایج پذیرفتهشده تقسیم کنید. مدل ارزان با نرخ خطای بالا ممکن است از مدل گران دقیقتر هزینه بیشتری ایجاد کند.
آیا Retry درخواست ناموفق رایگان است؟
نه لزوماً. نوع خطا و مرحله اجرای درخواست تعیین میکند که Usage ثبت شده یا نه. اگر پاسخ از دست رفته باشد، ممکن است Provider کار را انجام داده باشد؛ هزینه را با صورتحساب و شناسه تلاشها تطبیق دهید.
آیا Avaztek AI کنترل بودجه و مصرف را جایگزین مدیریت مالی میکند؟
سامانه امکان Quota و مشاهده Usage را در معماری درگاه معرفی میکند، اما تطبیق هزینه با نرخ واقعی Provider و سیاست مالی سازمان همچنان لازم است. برای ارزیابی نیاز خاص، از فرم درخواست فنی استفاده کنید.
جمعبندی: بهینهسازی از هزینه هر پاسخ درست شروع میشود
برای کاهش هزینه API هوش مصنوعی، ابتدا Usage واقعی و درخواستهای تکراری را ببینید، بعد ورودی را کوتاه کنید، Cache ایمن بسازید و مدل مناسب هر کار را با آزمون انتخاب کنید. بودجه پروژه نیز باید در زمان اجرای همزمان درخواستها کنترل شود، نه فقط پس از دریافت صورتحساب. اگر مصرف میان چند محصول پراکنده است، Avaztek AI را برای مدیریت متمرکز مدل، سهمیه و گزارش مصرف بررسی کنید.
نظرات و گفتوگو
نظرها پس از تایید مدیر منتشر میشوند. پاسخهای رسمی مدیر با نشان مشخص نمایش داده میشوند.